옛 색인을 정답지로 두지 않는 검증
마이그레이션 검증의 합격선은 대개 한 줄로 적힙니다. 새 시스템이 옛 시스템과 같은 값을 내면 통과. 대부분의 팀이 이 줄을 의심하지 않고 쓰는데, 이 문장은 옛 시스템을 정답지로 놓고 있다는 걸 잘 드러내지 않아요. 정답지에 오답이 섞여 있다면, 완벽하게 일치하는 새 시스템은 그 오답까지 성실하게 베껴 쓴 시스템이 됩니다.
카카오 커머스가 클레임(취소·교환·반품) 검색 색인을 변경 알림 기반에서 CDC로 옮긴 기록은 바로 이 합격선을 의심하는 데서 힘이 나옵니다. 대상부터 가볍지 않아요. 담당자들이 하루 수만 건을 조회하면서 반품 요청 상태로 사흘 넘게 멈춘 건 같은 것을 골라 처리하는 화면이고, 문서 한 건에 필드가 40개를 넘습니다. 검색은 Elasticsearch에 먼저 묻고, 색인에는 검색용 필드와 번호만 담아 뒀다가 그 번호로 원본에서 상세를 읽어 옵니다. 사본이 원본과 어긋나면 화면이 어긋나고, 그 화면을 보고 내리는 판단까지 어긋나는 자리예요. 제목부터 「옮기는 것보다 증명이 어렵다」이고, 글의 무게도 전환 자체보다 '맞다는 걸 어떻게 보였나'에 실려 있거든요. CDC 도입기로 읽으면 절반만 읽는 셈이고, 검증을 설계하는 교본으로 읽어야 남는 게 많습니다. 저는 그쪽으로 다시 풀어 보겠습니다.
차이가 나오면 누구를 먼저 의심할까
두 색인의 전체 문서를 대조했더니 83만 건 중 166건이 달랐습니다. 0.02%. 불일치는 전부 같은 플래그 하나가 반대값인 경우였죠. 이런 숫자를 받으면 거의 모든 개발자가 새 코드부터 엽니다. 이 팀도 처음엔 새 색인이 값을 뒤집어 기록하는지 의심했는데, 양쪽 코드가 같았어요.
원인은 옛 색인 쪽에 있었습니다. 그 플래그를 판정할 때 읽는 테이블에 행이 여러 개 있었고, 그중 어느 행이 선택되는지가 실행마다 달랐던 겁니다. 새 색인이 옛 색인과 어긋난 게 아니라, 옛 색인이 같은 입력에서도 같은 값을 내지 못하던 상태였던 거죠.
카카오 팀은 차이의 출처를 세 곳으로 나눠 둡니다. 대조 방법, 기존 색인, 새 색인. 대조 방법이 틀린 채 새 색인을 고치면 멀쩡한 코드를 망가뜨리고, 기존 색인을 정답으로 놓으면 이렇게 됩니다.
"기존 색인을 정답으로 전제하면 기존 결함을 그대로 복제하게 됩니다."
테스트 이론에서 오라클 문제라고 부르는 것을 현업의 말로 옮긴 문장이에요. 마이그레이션에서는 오라클이 늘 '옛 시스템'으로 자동 지정된다는 점이 함정이고요. 오래된 시스템일수록 그 로직을 끝까지 아는 사람이 없는데, 바로 그 시스템이 채점자 자리에 앉습니다.
이 글에서 첫 번째 차이와 두 번째 차이가 각각 다른 출처에서 나온 것도 좋은 예시입니다. 문서 수가 비슷하지만 같지 않았던 건 대조 방법 탓이었어요. 전체 색인은 실행 시점 기준으로 최근 몇 년 치만 보존하는데, 두 색인을 서로 다른 날 만들었으니 보존 기간의 시작점이 달랐던 거죠. 연도별로 다시 세자 차이는 그 시작점이 걸친 해에만 남고 이후 연도는 전부 0이었습니다. 166건은 그다음, 옛 색인 쪽 출처였고요.
하나 더 봐야 할 것은 166건을 찾아낸 대조가 어떤 대조였느냐입니다. 전환 판정에 쓴 값 대조는 신규 변경 7일 전수와 과거 구간의 경로별 표본이었고, 7일 전수에서 필드 불일치는 0건이었어요. 166건은 그 바깥, 두 색인의 전체 문서를 맞댄 대조에서 나왔습니다. 판정 기준의 대조만 돌렸다면 이 비결정성은 수면 위로 올라오지 않았을 겁니다. 저는 여기서 판정용 대조와 탐색용 대조를 처음부터 따로 계획해야 한다고 봐요. 통과 여부를 가리는 대조는 좁고 정확해야 하고, 결함을 찾는 대조는 넓고 둔해도 되거든요.
건수·값·지연, 서로의 빈칸
검증 축을 셋으로 나눈 이유는 지표 하나만 보면 각자 다른 방식으로 거짓말을 하기 때문입니다. 그 설명을 제 식으로 표 하나에 모으면 이렇습니다.
| 축 | 혼자 볼 때 놓치는 것 | 그 빈칸을 덮는 쪽 | | --- | --- | --- | | 건수 | 수는 같은데 담긴 문서가 다른 경우 | 양방향 존재 확인 | | 값 | 값은 맞는데 반영이 늦어 화면이 과거를 보여주는 경우 | 지연 | | 지연 | 빠르지만 애초에 수집되지 않은 변경 | 건수·존재 확인 |
하나라도 빠지면 나머지 둘의 결론이 같이 약해지는 배치예요. 양방향 확인은 그래서 들어갔습니다. 기존 색인에 있고 새 색인에 없는 문서만 보면 '빠진 것'만 찾게 되고, 새 색인에만 있는 문서까지 봐야 두 색인이 같은 문서를 담았다고 말할 수 있으니까요. 이 방향의 결과는 0건이었습니다.
제가 가장 실무적이라고 본 대목은 범위를 비용으로 정한 부분입니다. 문서 건수는 집계라 싸니까 전체를 봤고, 값 대조는 양쪽에서 문서를 꺼내 필드 단위로 비교해야 하니 건당 비용이 커서 대상을 나눴어요. 상태가 더 이상 바뀌지 않는 과거 구간은 표본으로, 코드가 돌아가는 동안 계속 생겨나는 신규 변경은 전수로. 대조하는 대상의 성질에 맞춰 방법을 고른 겁니다.
표본을 유입 경로별로 뽑은 이유도 짚어 둘 만합니다. 생성·갱신·보완 배치·전체 색인 배치는 처리 로직도, 결함이 생기는 방식도 다릅니다. 경로를 구분하지 않고 뽑으면 건수가 많은 경로가 표본을 채우고, 드물게 도는 경로는 아예 안 들어올 수 있어요. 결함은 대개 드물게 도는 경로에 숨어 있죠. 신규 변경을 7일 연속으로 본 것도 같은 계산입니다. 하루치로는 그날 일어난 상태 전이와 경로의 조합만 확인할 수 있으니까요. 관측 기간에 한 번도 나타나지 않은 상태 전이는 확인하지 못했다는 점도 한계 목록에 그대로 적혀 있어요.
지연은 두 개로 쟀습니다. 원본의 수정시각부터 색인 반영까지의 절대지연, 그리고 같은 문서를 두 색인이 각각 언제 반영했는지 비교한 상대지연. 절대지연만 보면 그 기간의 트래픽이 좋았던 덕일 수 있으니, 같은 조건을 겪은 두 색인을 맞붙여 외부 변수를 지운 겁니다. 대조군을 붙인 셈이죠. 결과는 절대지연 중간값이 14.3초에서 0.8초로 약 18배 줄었고, 상대지연은 측정 대상 전부에서 새 색인이 먼저였습니다.
이렇게 세 축을 다 통과하고도 이 팀은 선을 하나 긋습니다. "두 색인이 일치한다는 것이 두 색인이 모두 옳다는 뜻은 아닙니다." 양쪽이 같은 원인으로 같은 오답을 내면 대조는 그걸 못 잡아요. 일치는 증명이 아니라, 증명 가능한 범위가 어디까지인지 알려주는 표시입니다.
순서를 맞추지 않고, 결과가 모이게
검증이 이만큼 정돈될 수 있었던 건 설계가 먼저 증명하기 쉬운 쪽으로 돌아가 있었기 때문이라고 봅니다. 전환 전 구조부터 보면 이유가 보여요.
전환 전에는 원본에 변경이 생기면 알림이 나가고, 알림을 받아 원본을 다시 읽어 문서를 만들었습니다. 원본을 고치는 일과 알림을 보내는 일이 한 트랜잭션이 아니면 사본이 어긋나는 길이 둘 생겨요. 한쪽만 성공해 알림이 사라지는 길, 그리고 둘 다 성공했는데 같은 데이터를 고친 두 작업이 원본과 사본에 다른 순서로 도착하는 길. Martin Kleppmann이 이중 쓰기(dual write)라고 부른 문제입니다. 뒤쪽이 더 고약한 이유는 실패한 작업이 없으니 오류도 기록되지 않는다는 데 있습니다. 에러 로그가 없는 불일치는 모니터링이 잡아 주지 않아요.
이 팀은 그 빈틈을 경로를 늘려서 메워 왔습니다. 서비스가 직접 보내는 알림에 더해, 다른 조직의 데이터가 바뀌는 경우를 위해 5초마다 update_ts 컬럼을 읽는 폴링 잡을 두고, 그래도 새는 구간을 위해 12시간 주기 보완 배치를 실시간 처리 안에 함께 돌렸죠. 경로를 아무리 늘려도 발행 자체가 일어나지 않는 경우는 막을 수 없습니다. 발행 경로를 보강하든 아웃박스로 변경과 이벤트를 한 트랜잭션에 묶든, 발행 책임은 여전히 서비스에 남아요. 데이터베이스가 복제를 위해 원래부터 쓰는 로그를 읽으면 발행할 주체 자체가 필요 없어지고, 커밋된 변경은 반드시 로그에 남습니다. CDC를 고른 이유가 여기 있습니다. 새 선택지도 아니었어요. 2019년 발표 때도 검토 기록이 있었지만 새 기술 스택과 전담 지원이 필요해 보류했고, 6년이 지나 그 부담을 감당할 수 있게 된 시점에 실행했습니다. 무엇이 달라져 감당할 수 있게 됐는지는 나와 있지 않은데, 같은 결정을 앞둔 팀이 가장 궁금해할 대목이 거기라 아쉬운 부분이에요.
순서 문제는 CDC로도 사라지지 않았어요. 로그는 커밋 순서대로 기록되지만 토픽과 파티션으로 나뉘면서 순서가 보장되는 범위는 파티션 하나로 줄어듭니다. 파티션 키는 원본 행이고 색인 문서는 클레임 단위라, 한 문서를 이루는 변경들이 여러 파티션에 흩어지죠. 실패한 건은 10초 간격으로 재시도하니 그사이 뒤의 변경이 먼저 반영되기도 하고요.
흔한 해법은 순서를 복원하는 쪽입니다. 이 팀은 순서와 상관없이 같은 결과로 모이도록 만들었어요. 생성보다 갱신이 먼저 도착하면 갱신할 문서가 아직 없으니 아무것도 하지 않고 끝내고, 나중에 도착한 생성이 원본에서 문서 전체를 읽으면서 최신 값을 담습니다. 갱신끼리 순서가 뒤집히면 색인에 적어 둔 반영 기준 시각과 이번 이벤트의 시각을 비교해, 이미 더 나중 것이 반영돼 있으면 건너뜁니다.
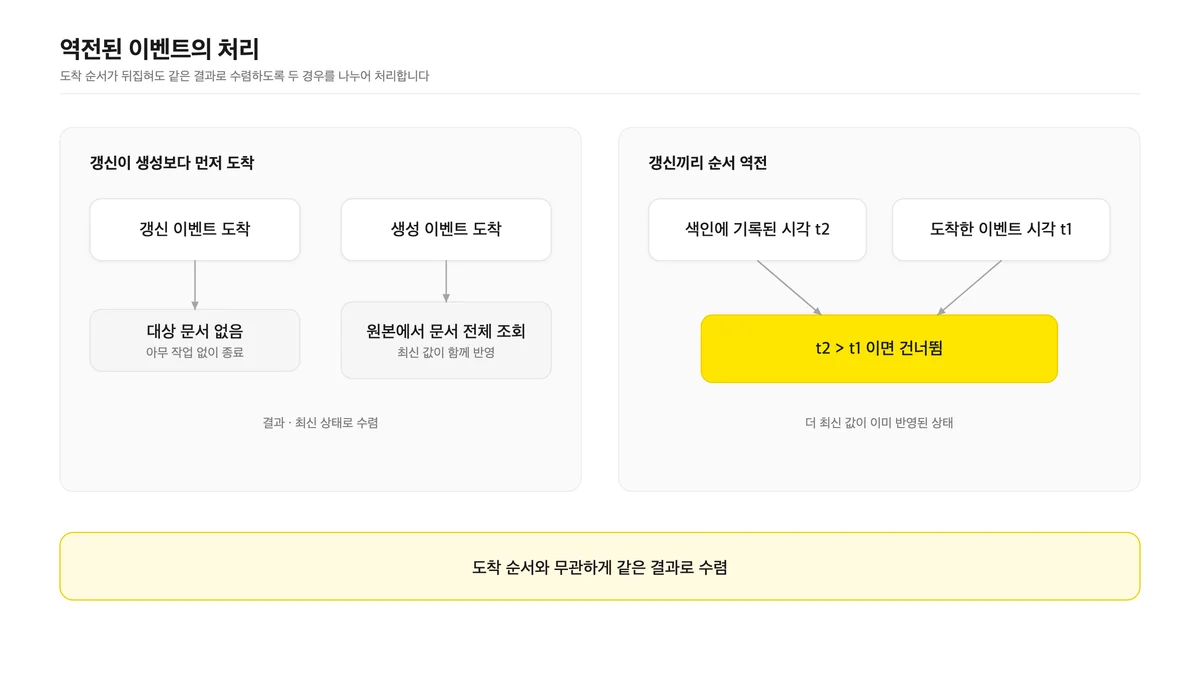
이 그림에서 제가 보는 건 검증과의 관계입니다. 순서를 복원하는 설계라면 '모든 이벤트가 올바른 순서로 처리됐는가'를 증명해야 하는데, 이건 결과물을 대조해서는 확인하기 어렵습니다. 수렴하는 설계라면 질문이 '최종 상태가 원본과 같은가' 하나로 줄어들고, 그건 정확히 값 대조가 답하는 질문이에요. 설계가 검증 가능한 질문을 만들어 준 겁니다. 전환 전에 알림에 값 없이 시각과 번호만 실었던 제로 페이로드도 같은 생각이었죠. 값을 실으면 순서가 뒤집혔을 때 과거 값이 최신 값을 덮을 수 있으니, 번호만 보내 도착 순서와 무관하게 마지막 상태가 남게 했습니다. 대가는 알림마다 17개가 넘는 테이블을 다시 조회하는 비용이었고요.
처리 경로를 넷으로 다시 짠 것도 증명의 단위를 나눈 일로 읽힙니다. 클레임이 처음 생길 때 문서 전체를 만드는 생성 파이프라인, 이후 변경에서 바뀐 필드만 고치는 갱신 파이프라인, 실시간 처리에서 떼어 내 누락 구간만 메우는 보완 배치, 최초 구축과 재구축을 맡는 전체 색인 배치. 로직은 넷이 다르지만 문서를 구성하는 코드는 Spark 위에서 공유합니다. 전체 색인 배치를 따로 둔 근거로는 Netflix의 DBLog 논문을 듭니다. 트랜잭션 로그는 변경의 전체 이력을 담고 있지 않아서 로그만으로는 전체 상태를 복제할 수 없고, 전체 상태를 가져오는 경로가 따로 있어야 한다는 거죠. 앞에서 표본을 유입 경로별로 뽑은 이유가 여기서 이어집니다. 경로가 넷이면 결함이 생기는 방식도 넷이니까요.
기준시각 오염도 같은 줄기에서 읽힙니다. 건이 특정 상태에 머문 기간을 원본의 수정시각(modified_at)으로 계산했더니, 반품 접수 9일째 건에서 귀책이 판매자인지 구매자인지만 바꿔도 체류 기간이 하루로 바뀌었어요. 사흘 넘게 멈춘 건을 거르는 목록에서 그 건은 빠졌고요.
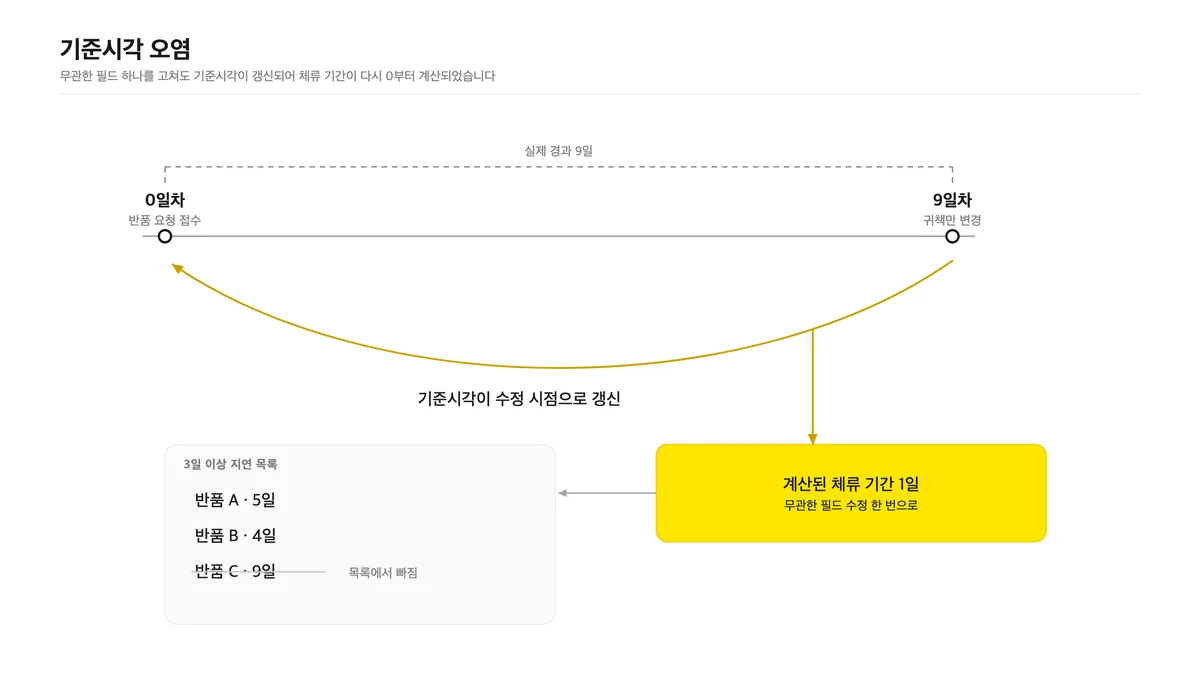
여기서 카카오 팀은 원본 쪽을 탓하지 않습니다. "클레임 서비스가 잘못 동작한 것은 아닙니다." 어느 필드가 바뀌어도 갱신된다는 게 그 컬럼의 정의였고, 결함은 그 값을 아무 조건 없이 기준시각으로 쓴 색인 쪽에 있었다는 거죠. 남의 컬럼을 그 정의 밖의 의미로 쓰면 결함은 쓰는 쪽에서 생깁니다. 고친 방식도 정직했어요. 상태가 바뀐 시점만 따로 적재해 그 구간은 기록에서만 기준시각을 계산하고, 적재 이전의 오래된 건은 수정시각을 그대로 쓰되 정확한 구간과 그렇지 않은 구간의 경계를 설계 문서에 남겼습니다. 증명할 수 없는 구간을 숨기지 않은 거예요.
세 축 바깥에서 터진 것
전환 판정이 끝난 뒤에 문제가 하나 더 나왔습니다. 전체 색인 배치가 원본 데이터베이스에 한계 수준의 부하를 걸고 있었던 거예요. 이 배치는 서비스 트래픽을 피하려고 매일 복사하는 HDFS 사본을 읽고, 사본에 없는 개인정보만 원본에서 조회합니다. 조회가 단순하다고 여겼던 탓에 원인을 찾는 데 시간이 걸렸다는 고백도 있어요.
DBA가 보니 초당 질의수는 감당할 수준이었고, 문제는 배치 한 번에 쏟아지는 질의 총량이었습니다. 원인은 세 겹이었어요. 묶음 크기가 약 200건으로 코드에 박혀 있어 운영 중에 바꿀 수 없었고, 개인정보를 읽는 단위와 실제 처리 단위가 달랐고, 속도 제한이 실행 단위마다 따로 걸려 병렬도를 올리면 부하도 같이 올랐습니다. 두 번째가 가장 컸어요. 상자 하나에 상품이 다섯 개면 그 상자의 수령인을 다섯 번 조회했고, 중복 조회는 평균 45회였습니다. 1,643만 건을 조회했는데 실제 대상은 36만 6천 건이었죠.
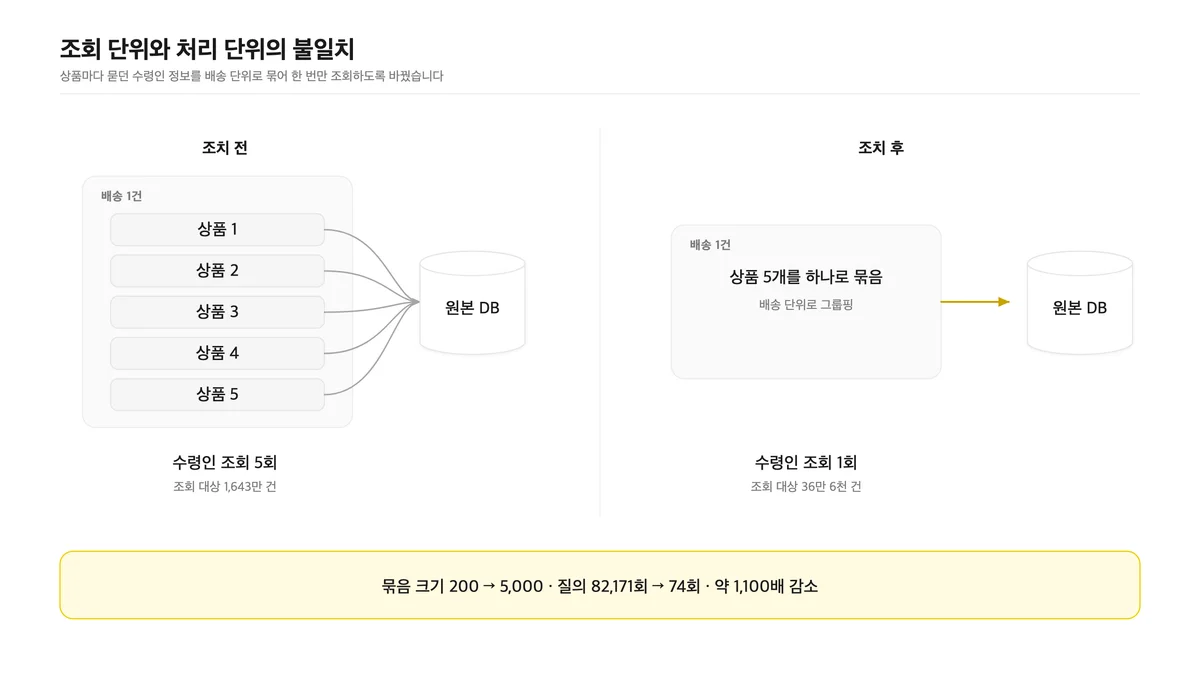
묶음 크기를 설정으로 빼서 5,000으로 올리고(25배), 배송 단위로 묶어 한 번만 조회하게 하고(45배), 속도 제한을 배치 전체의 총량으로 바꾸자 질의는 82,171회에서 74회로, 약 1,100배 줄었습니다. CPU 사용량은 45% 내려갔고요.
숫자를 나란히 놓으면 보이는 게 있어요. 질의가 1,100배 줄어드는 동안 소요시간은 12.9분에서 11.6분, 10%쯤 줄었을 뿐입니다. 배치 시간만 지켜봤다면 이 배치는 '그럭저럭 괜찮게 도는 배치'로 보였을 겁니다. 초당 질의수도 문제없어 보였으니, 속도와 시간을 재는 지표 둘이 나란히 총량을 가리고 있었던 셈이죠.
저는 이 대목이 이 글에서 필자들 스스로는 짚지 않은 가장 큰 교훈이라고 봐요. 누락·값·지연은 셋 다 '색인이 맞나'를 묻는 축이고, '원본이 버티나'를 묻는 축은 없었습니다. 그래서 부하는 판정을 통과한 뒤 운영에서 발견됐고요. 마이그레이션 검증에는 네 번째 축, 원본과 이웃 시스템이 치르는 비용이 들어가야 합니다. 그리고 그 축은 초당 수치가 아니라 1회 총량으로 재야 하고요.
CDC 자체에도 글에 나오지 않는 비용이 있습니다. 발행 책임을 없앤 대신, 색인이 원본 테이블의 물리 구조에 직접 묶이게 됐어요. 다른 조직이 관리하는 테이블의 컬럼 하나가 바뀌면 그 변화가 이제 알림을 거치지 않고 로그로 곧장 들어옵니다. 기준시각 오염이 '남의 컬럼을 정의 밖으로 쓴 결함'이었다는 걸 떠올리면, 같은 종류의 결함이 생길 자리가 줄었다고 단정하기는 어렵습니다. 스키마 변경을 누가 언제 알려 주는지, 그 약속을 어디에 적어 두는지가 이 구조를 운영하는 팀이 다음으로 정해야 할 일이라고 생각해요.
에이전트에게 넘긴 건 대조, 사람이 쥔 건 판정
7일 연속 전수 대조는 사람이 매일 하지 않았습니다. 반복되는 대조 실행과 집계 정리는 에이전트가 맡았고, 어느 쪽이 맞는지 판정하는 일과 무엇을 포기할지 정하는 일은 사람이 맡았어요. 위임의 기준을 난이도가 아니라 검증 가능성에 둔 것, 즉 결과가 틀렸을 때 그 사실을 확인할 수 있는 작업만 넘긴 게 이 대목의 전부입니다.
테스트는 검증 환경에서 문제를 발견할 때마다 하나씩 늘어 19건에서 32건이 됐고, 설계서는 교차 검증으로 맞췄습니다. 설계서에 적혀 있는데 실제로는 없는 설정이 나오면 설계서 쪽을 고쳤어요. 설계서를 검증 기준으로 쓰려면 설계서부터 사실과 맞아야 하니까요. 테스트를 쓰게 하는 것만으로는 부족하다는 근거도 붙어 있습니다. 실제 코드에서 뽑은 함수 3,909개로 만든 벤치마크에서 모델이 생성한 테스트가 주입된 결함을 잡은 비율은 평균 40.21%였어요.
제가 이 섹션에서 밑줄 친 건 두 문장의 대비입니다. "정리해 줘"라는 지시는 결과를 믿는 것 외에 확인할 길이 없고, 같은 일을 "이 기준으로 집계해 연도별로 나누고 0이 아닌 행만 남겨라"로 바꾸면 결과를 검사하고 고칠 수 있다. 그리고 뒤 문장을 쓸 수 있었던 건 앞에서 본 대조 설계가 무엇을 집계하고 어떻게 나누고 어떤 행이 남아야 하는지를 이미 정해 뒀기 때문입니다. 에이전트 위임의 품질을 정하는 건 프롬프트 솜씨보다 그 앞의 검증 설계예요. 검사 가능한 지시는 검사 기준이 먼저 있어야 쓸 수 있으니까요.
166건이 이 경계를 그대로 보여 줍니다. 위임해서 얻은 건 '83만 건 중 166건이 다르고 전부 같은 플래그'라는 사실까지였어요. 코드를 의심할지 설계를 의심할지는 사람이 정했고, 그 판단이 반대였다면 옛 색인의 로직이 새 색인으로 고스란히 옮겨졌을 겁니다. 이 팀이 속도를 성과 지표로 쓰지 않고 '되짚는 비용이 늘지 않은 것'을 성과로 본 것도 같은 맥락이에요. 인용된 METR 실험에서 숙련 오픈소스 개발자들은 AI 도구로 20% 빨라졌다고 답했지만 실제 수행 시간은 19% 늘었습니다. 2025년 초의 도구를 대상으로 한 실험이고, METR이 2026년 2월에 낸 후속 보고는 지금은 더 빨라졌을 것으로 보면서도 개발자의 자기 보고 속도는 믿기 어렵다는 관찰을 유지했어요. 체감 속도는 증명이 아니니까요.
같이 읽을 자료, 고른다면 셋
글 끝에 붙은 참고 자료가 여덟 개인데, 이 글을 읽고 다음으로 하나만 더 읽는다면 저는 Martin Kleppmann의 Using logs to build a solid data infrastructure (or: why dual writes are a bad idea)를 고르겠습니다. 이중 쓰기가 왜 에러 없이 어긋나는지를 이 글보다 넓은 맥락에서 설명해 주고, CDC를 고르는 이유의 뿌리가 거기 있거든요.
두 번째는 Netflix의 DBLog: A Watermark Based Change-Data-Capture Framework(Andreas Andreakis, Ioannis Papapanagiotou)입니다. 전체 색인 배치를 왜 따로 둬야 하는지, 로그와 스냅샷을 잠금 없이 함께 돌리는 워터마크 기법이 무엇인지가 여기 있어요. CDC를 실제로 도입하려는 팀이라면 이 논문이 첫 번째일 수도 있습니다.
세 번째는 Dong Huang, Jie M. Zhang, Mark Harman 등의 Benchmarking LLMs for Unit Test Generation from Real-World Functions입니다. 테스트를 에이전트에게 쓰게 하면 안심이 된다는 감각에 숫자로 찬물을 끼얹는 자료라, 위임 경계를 정하는 사람에게 필요합니다.
나머지 다섯, Birgitta Böckeler의 하네스 엔지니어링 글과 TDD를 에이전트 루프에 넣은 실험, Simon Willison의 Designing agentic loops, The New Stack이 다룬 Addy Osmani의 코드 리뷰 병목 이야기, METR의 생산성 실험은 에이전트에게 일을 맡기는 태도에 관한 의견과 실험이라, 이 글의 논지를 다른 각도에서 다시 확인해 주는 정도예요. 시간이 한정돼 있다면 위의 셋이 먼저입니다.
다음 검증 계획서에 넣을 두 줄
CDC로 갈지 말지는 팀마다 사정이 다릅니다. 이 글에서 옮겨 갈 수 있는 건 그 앞의 습관이에요. 마이그레이션 검증 계획서를 쓰는 팀이라면 두 줄을 더 넣었으면 합니다. 하나, 차이가 나오면 대조 방법과 옛 시스템을 새 시스템보다 먼저 의심한다. 둘, 원본과 이웃 시스템이 치르는 비용을 검증 축에 넣고 초당 수치가 아니라 1회 총량으로 잰다.
옛 시스템이 오래돼서 그 로직을 끝까지 아는 사람이 남아 있지 않은 팀일수록 첫 줄이 중요하고, 원본 데이터베이스를 다른 조직이 운영하는 구조일수록 둘째 줄이 중요합니다. 두 줄 다 해당되는 팀이라면, 새 시스템이 옛 시스템과 똑같은 값을 낸다는 보고를 받았을 때 축하보다 질문을 먼저 하는 게 맞습니다. 그 일치가 무엇까지 증명하고 무엇은 증명하지 못하는지.