'입력에 없음'과 '세상에 없음'을 가르는 표시 하나, AI 아침 브리핑 운영기에서 고른 셋
어느 날 아침 브리핑이 8일째 멈춘 티켓을 "막힌 이유가 안 보인다"며 '여력 되면 할 일'로 올렸습니다. 기다리는 이유는 그 티켓 마지막 코멘트의 301자째부터 적혀 있었어요. 수집 스크립트가 코멘트를 300자에서 잘라 넘겼고, 잘렸다는 표시가 없으니 모델은 끊긴 문장을 완결된 코멘트로 읽었습니다. 세어 보니 오래 멈춘 티켓 12건 중 11건이 이렇게 잘리고 있었습니다.
AI 엔지니어 박장원의 'Claude Code 운영기' 3편은 집 서버에서 claude -p로 매일 아침 8시 Discord에 보내는 티켓 브리핑을 3개월간 고친 기록입니다. 글 첫머리에 자주 생기는 문제와 처방을 아홉 줄로 짝지어 놨는데, 저는 이 중 셋을 어떤 LLM 파이프라인에도 옮겨 쓸 수 있는 원칙으로 골랐습니다. 하나에는 조건을 달고, 나머지는 이 브리핑 고유의 운영 팁으로 넘기겠습니다. 결론부터 말하면 세 원칙은 모두 같은 일을 합니다. 모델이 '입력에 없는 것'을 '세상에 없는 것'으로 착각하지 않게 만드는 일이요.
고른 하나: 자를 때는 반드시 잘랐다고 적는다
위의 사고 뒤에 박장원이 바꾼 건 세 가지입니다. 코드 곳곳에 흩어져 있던 자르기를 함수 하나로 모으고, 잘리면 끝에 원래 길이를 붙였습니다. "…[전체 341자 중 200자]" 같은 식으로요. 함수 주석에 적힌 한 문장이 이 글 전체의 요약입니다. 자르면 반드시 표시한다, 표시가 있어야 '입력에 없음'과 '티켓에 없음'이 갈린다.
```python def clip(raw: str | None, limit: int) -> str: """자르면 반드시 표시한다. 표시가 있어야 「입력에 없음」과 「티켓에 없음」이 갈린다.""" text = " ".join((raw or "").split()) if len(text) <= limit: return text return text[:limit] + f"…[전체 {len(text)}자 중 {limit}자]" ```
여기에 프롬프트에 "잘린 입력을 근거로 막힌 이유가 없다고 판단하지 말라"를 넣고, '막힌 이유가 안 보인다'를 추천 사유에서 아예 뺐습니다. 근거가 없는 것 자체가 추천 사유면 잘려서 안 보이는 것도 그대로 추천이 되니까요. 그리고 사고가 난 실제 코멘트를 테스트 데이터로 두고 결정 문장이 입력까지 오는지 검사합니다.
저는 이게 RAG든 요약이든 에이전트든 LLM에 텍스트를 넘기는 모든 시스템이 가져가야 할 원칙이라고 봅니다. 검색 결과 상위 몇 건만 넘길 때, 긴 문서를 토큰 한도에 맞춰 자를 때, 우리는 대개 그 사실을 모델에게 말하지 않습니다. 모델은 받은 것이 전부라고 가정하고, 그 가정 위에서 '이런 내용은 없다'고 자신 있게 말합니다. 같은 종류의 사고가 3주에 세 번 났는데 매번 그때 문제가 된 곳의 한도만 올려서 다른 곳의 300자 제한은 그대로 남아 있었다는 고백도 뼈아픕니다. 한도를 올리는 건 증상 치료고, 잘림을 표시하는 게 원인 치료예요.
고른 둘: 모델이 검증할 수 없는 계산은 스크립트가 끝낸다
처음 수집 스크립트는 열린 티켓을 우선순위 순으로 넘겼고 시간 정보는 마감일뿐이었습니다. 그러자 마감이 7주 남은 티켓이 이틀 연속 1순위에 오르고 그날 마감인 티켓이 2순위로 밀렸어요. 브리핑은 "남은 시간은 7주지만"이라고 쓰면서도 그 티켓을 1순위에 뒀습니다.
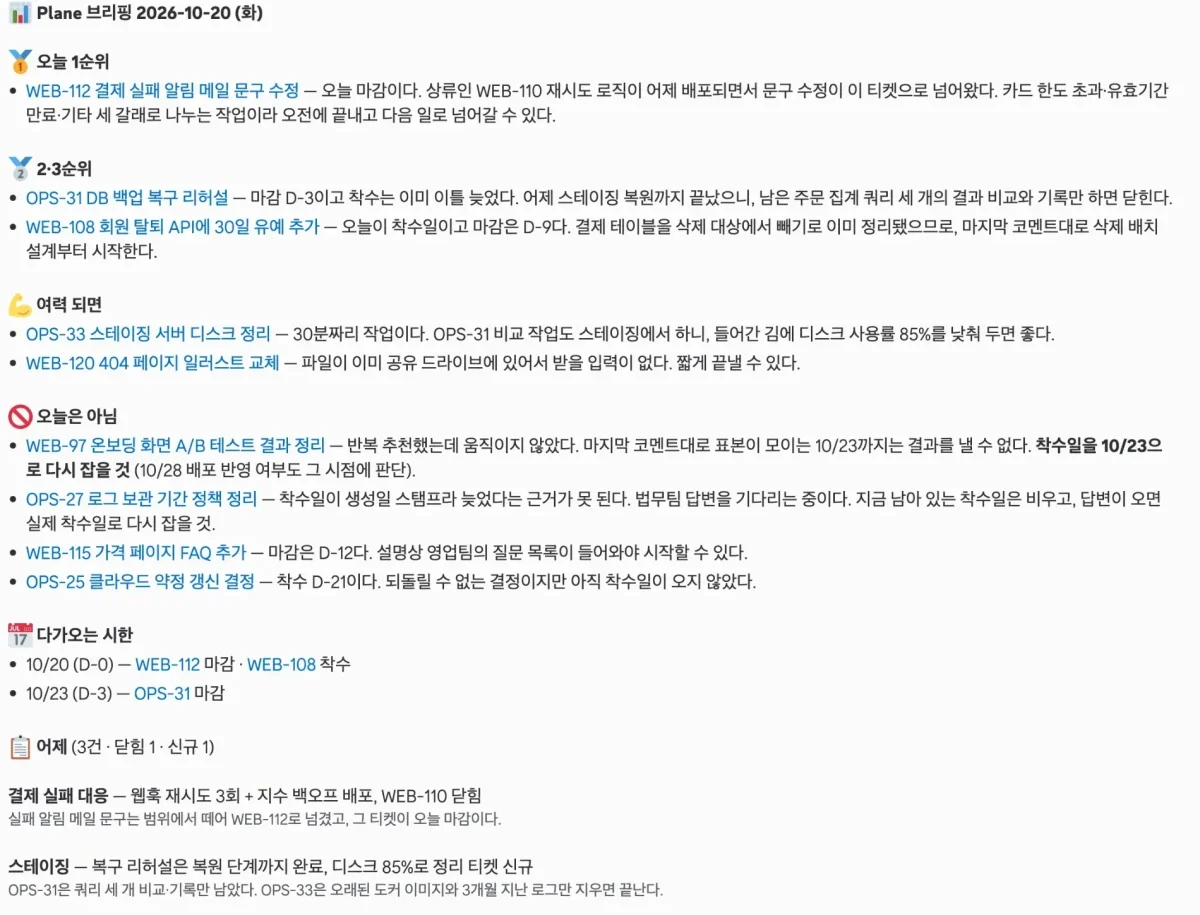
그는 티켓부터 고쳐 high 6건을 내리고 9건에 시작일을 넣은 뒤, 스크립트가 시작일 순으로 정렬하고 D-day와 요일까지 계산해 넘기게 했습니다. 입력에는 "D-N은 오늘 기준 남은 일수다(계산 완료 — 다시 세지 말 것)"라는 안내까지 붙였고요. 날짜 뺄셈을 LLM에 맡기면 매일 아침 우선순위에 검증할 수 없는 계산이 하나 끼어든다는 설명입니다.
이 원칙의 범위는 날짜보다 넓습니다. 정렬, 합계, 비율, 기간처럼 정답이 하나인 계산은 코드로 끝내고, 모델에게는 판단만 남기는 것. 같은 맥락의 디테일이 하나 더 있어요. 티켓의 updated_at은 코멘트를 달아도 바뀌지 않아서, 6일 전에 코멘트를 단 티켓이 '41일 멈춤'으로 나간 일이 있었어요. last_activity_at으로 바꿔 해결했는데, 이것도 모델이 아니라 입력의 숫자가 틀렸던 사례입니다. 모델은 받은 숫자를 의심할 방법이 없어요. '어제 활동'을 마지막 실행 이후로 세다가 같은 날 다시 돌리면 0건이 되는 문제도 '어제 0시부터 오늘 0시까지'라는 고정 구간으로 풀었습니다. 기준이 흔들리는 숫자는 모델에게 넘기기 전에 코드에서 못 박아야 합니다.
고른 셋: 판단만 할 모델에게는 도구를 주지 않는다
브리핑을 쓰는 claude -p는 도구를 하나도 주지 않고 부릅니다. MCP 서버를 띄우지 않고 파일 읽기나 Bash 같은 내장 도구까지 전부 뺍니다. 계기가 흥미로워요. 도구가 열려 있던 시절 레포 폴더에서 같은 호출을 돌렸더니, 그날 입력에 '이 레포의 프롬프트를 고쳐라'라는 티켓이 있어서 브리핑 대신 저장소를 뒤지고 "테스트를 돌릴까요?"라고 물었다는 겁니다. 같은 호출로 재 보니 입력 토큰도 23,955에서 3,554로 줄었고요.
저는 이 장면이 보안 쪽에서도 의미가 크다고 봅니다. 티켓 제목 하나가 에이전트의 행동을 바꿨으니, 이건 의도하지 않은 프롬프트 주입입니다. 데이터를 읽고 글을 쓰기만 하면 되는 작업에 도구를 열어 두면, 데이터 안의 문장이 지시로 바뀔 수 있어요. 수집은 스크립트가 하고 판단은 도구 없는 모델이 하는 분업은 비용 최적화이기 전에 안전 설계입니다.
박장원이 정리한 다른 사람들의 AI 아침 브리핑을 보면 이 선택의 의미가 더 분명해집니다. 가장 흔한 건 에이전트에 커넥터를 붙여 예약 실행하는 방식인데, 만들기는 쉽지만 비용과 결과가 매번 달라진다는 후기가 따라붙는다고 해요. Jira 모바일이 어제 집중한 일 셋과 오늘 볼 작업 셋을 보여 주고 Linear Pulse가 프로젝트 업데이트를 요약하듯 트래커에 들어 있는 요약도 있고요. 커넥터 방식은 매번 모델이 무엇을 읽을지까지 정하니 입력이 날마다 달라지고, 그래서 결과도 날마다 흔들립니다. 입력을 스크립트로 고정하면 모델의 판단을 디버깅할 수 있게 됩니다. 어제와 오늘 결과가 다르면 입력을 비교하면 되니까요. 컬리 기술 블로그가 MCP로 모으다가 비용과 속도 때문에 '반복되는 일은 스크립트로, 판단은 AI에'로 바꿨다는 사례, Jonathan Malkin이 셸 스크립트가 모은 입력을 도구 없는 호출에 한 번 넘긴다는 사례도 같은 결론으로 모입니다.
덤으로 하나: 프롬프트의 규칙보다 입력의 표시가 이긴다
셋을 고르고 나니 같은 원칙의 변주가 하나 더 보입니다. 시작일을 쓰기 시작하자 두 가지 문제가 생겼어요. 하나는 티켓을 만들며 그날 날짜를 시작일에 습관처럼 찍는 바람에 4개월 뒤에 할 일이 '착수 4일 지남'으로 1순위에 오른 일이고, 다른 하나는 high인데 3일째 손대지 않은 티켓에 붙는 방치 표시가 시작일을 일부러 미뤄 둔 티켓에까지 붙어 2순위로 올라온 일입니다. 프롬프트에는 분명 '시작일이 안 왔으면 오늘은 아님'이라는 규칙이 있었는데, 모델은 그 규칙보다 입력에 찍힌 방치 표시를 따랐습니다.
해법은 프롬프트를 더 세게 쓰는 게 아니라 입력을 고치는 쪽이었습니다. 시작일이 생성일과 같으면 스크립트가 '(생성일 스탬프)'를 붙여 모델이 설명과 대조해 판단하게 하고, 시작일이 미래인 티켓은 스크립트가 방치 표시에서 미리 뺐어요. 저는 이 대목이 프롬프트 엔지니어링에 대한 좋은 반례라고 봅니다. 모델은 지시문보다 데이터에 가까이 붙은 신호를 더 믿습니다. 규칙과 표시가 충돌할 수 있는 구조라면, 규칙을 문장으로 더 강조하기보다 애초에 충돌하는 표시를 만들지 않는 게 확실하죠.
비슷한 사고가 프롬프트 예시에서도 났습니다. 입력에 없는 값이 필요하면 모델은 프롬프트에서 찾는데, 구독 피드 브리핑의 첫 줄 채널 이름이 프롬프트 예시에 적어 둔 외부 뉴스레터 이름으로 나간 적이 있다고 해요. 그래서 그런 값은 스크립트가 입력에 넣어 주고, 예시의 티켓 번호는 ABC-1처럼 존재하지 않는 값으로 바꿨습니다. 프롬프트의 예시는 설명이 아니라 데이터로 읽힐 수 있다는 것, 그리고 모델에게 빈칸이 있으면 손에 닿는 가장 가까운 값으로 채운다는 것. 결국 앞의 세 원칙과 같은 얘기입니다.
조건을 달 하나: 완료 버튼 없이 코멘트로 알아채기
AI 브리핑의 가장 흔한 불만은 끝낸 일이나 일부러 미룬 일을 또 올린다는 것입니다. Marvin Harris는 이미 답장한 스레드가 계속 올라와 첫 주에 페이지 전체를 못 믿게 됐다고 썼고, Anthropic의 에이전트 자동화 글은 상황이 이미 바뀐 '아직 당신 답을 기다리는 중' 한 줄이 아예 빠진 항목 열 개보다 신뢰를 더 깎는다고 적었습니다. Gemini Daily Brief 같은 제품은 사용자가 항목마다 '완료'나 '무시'를 눌러 알려 주게 하는데, 박장원은 버튼 없이 브리핑이 티켓의 마지막 코멘트와 어제 추천 목록을 읽어 알아채게 했습니다. 프롬프트엔 "설명과 코멘트가 어긋나면 코멘트가 이긴다"고 적었고요.
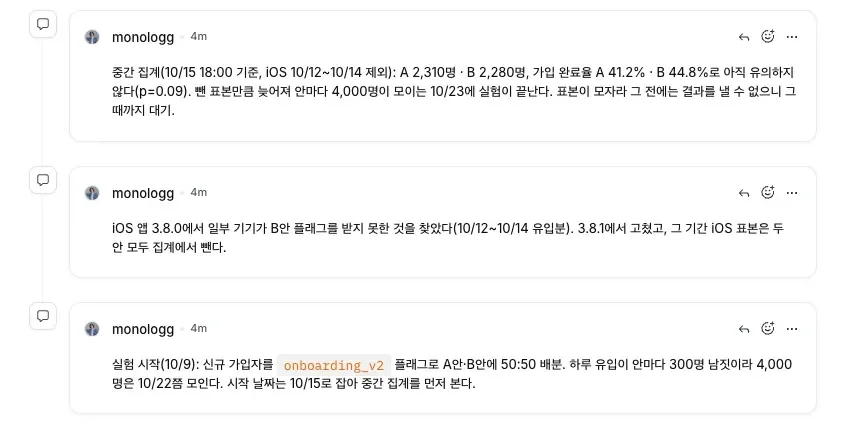
개인 운영으로는 훌륭한 설계지만, 저는 이게 그의 습관에 크게 기댄다고 봅니다. 그는 코멘트 앞에 경과를 쓰고 끝 문장에 다음 액션을 쓰는 편이라고 밝혔고, 브리핑은 그 끝 문장을 근거로 오늘 할 일인지 판단합니다. 여러 사람이 각자의 문체로 코멘트를 다는 팀 트래커라면 이 전제가 쉽게 깨지고, 결정이 슬랙이나 회의실에서 나고 티켓엔 안 적히면 아예 신호가 없습니다. 팀에 들인다면 '결정은 티켓 코멘트 끝 문장에'라는 규칙을 먼저 합의하거나, Gemini처럼 명시적 피드백을 받는 쪽이 더 견고할 겁니다. 두 번 추천했는데 손대지 않은 일은 다시 추천하지 않고 시한 재조정을 요구하는 추천 이력 장치는 팀에서도 그대로 쓸 만하고요.
나머지 처방, 예컨대 '오늘 뭐부터 하나'에만 답하게 하고 2,400자 안쪽으로 줄이기, 링크는 오늘 손댈 티켓에만 걸기(링크 48개에 메시지 5통이던 게 17개에 3통이 됐다고), 어느 단계에서 실패하든 같은 채널로 실패 알림 보내기, 보낸 기록은 발신이 성공한 뒤에만 남기기는 이 브리핑에 잘 맞는 운영 팁입니다. 특히 마지막 것은 거부(refusal)가 종료 코드 1에 stderr가 비어 있어 다른 실패와 구분되지 않고 JSON 출력의 stop_reason에만 드러난다는 관찰과 함께 기억해 둘 만합니다.
정리하면, LLM 파이프라인을 운영하는 팀이 오늘 할 일은 둘입니다. 모델에게 넘기는 모든 잘린 텍스트에 원래 길이를 붙이고, 프롬프트에 '입력에 없다는 이유로 없다고 판단하지 말라'를 넣으세요. 모델의 오답 상당수는 모델이 틀린 게 아니라, 우리가 알려 주지 않은 빈칸을 모델이 성실하게 믿은 결과입니다.