99.4%보다 먼저 만든 것, 학습에 쓰지 않은 1만 2천 건
새 모델을 전 고객사에 배포하고 얼마 지나지 않아, 일부 고객사에서 상담 평가의 neutral 판정이 크게 늘었습니다. 모델이 판단을 피하는 것처럼 보였고, 되돌리는 게 가장 안전해 보이는 상황이었죠. 채널톡 AI팀은 되돌리지 않고 neutral이 늘어난 고객사 6곳을 뜯어봤습니다. 결과는 반대였습니다. 새 모델이 '판단할 근거가 없으면 neutral'이라는 채점 기준을 기존 상용 LLM보다 더 정확히 지키고 있었던 거예요.
저는 채널톡의 이 사례에서 이 장면이 99.4%라는 숫자보다 중요하다고 봅니다. 상담 분석 작업을 상용 LLM에서 직접 학습한 작은 모델 하나로 옮겨 비용을 99.4% 줄이고 세 작업 모두 성능까지 높였다는 게 글의 헤드라인이지만, 그 결과를 믿을 수 있게 만든 건 모델이 아니라 학습보다 먼저 만든 평가 인프라였습니다. 이 사례를 따라 하려는 팀이 가져가야 할 것도 그쪽입니다.
무엇을 옮겼고 얼마나 아꼈나
채널톡은 모든 상담을 AI로 분석합니다. 고객이 정말 물어본 것을 뽑는 핵심 이슈 추출, 비슷한 상담을 묶는 토픽 배정, 상담이 잘 됐는지 보는 상담 평가. 상담 하나에 이 세 작업이 돌고, 그동안은 전부 상용 LLM이 처리했습니다.
이 구조가 생긴 배경도 짚어 둘 만합니다. 처음엔 상담 뒤 고객 만족도 설문(CSAT)을 받았는데, 대부분 답하지 않고, 아주 좋거나 아주 나빴던 사람만 답하고, 같은 상담에도 사람마다 점수가 달랐습니다. AI 상담원 ALF를 쓰는 고객사가 늘면서 "우리 AI 상담이 잘하고 있나"를 알려면 대화를 하나씩 열어 봐야 했고요. 그래서 AI가 종료된 상담을 100% 읽고 공감·배려, 고객 노력도, 고객 감정, 응대 정확도(ALF), 응대 품질(사람)을 항목별로 판정하는 CX Score를 만들었습니다. AI는 항목 판정까지만 하고 최종 점수는 정해진 수식으로 계산하니 같은 상담은 늘 같은 점수를 받습니다. 저는 이 설계를 좋게 봅니다. 모델에게 점수를 매기게 하지 않고 판정만 시키면, 모델이 바뀌어도 점수의 의미는 흔들리지 않으니까요.
점수가 생기자 "그래서 뭘 고쳐야 하죠?"라는 질문이 나왔고, 그 답이 토픽이었습니다. 사람이 붙이는 태그는 제각각이고 미리 정한 목록 밖의 새 이슈를 못 잡으니, 대화에서 고객이 정말 물어본 것을 뽑아 "택배가 안 움직여요"와 "신발이 아직 안 왔어요"를 같은 '배송 상태 확인'으로 묶고, 맞는 토픽이 없으면 미분류로 두었다가 반복 패턴이 보이면 새 토픽을 만듭니다. 여기에 CX Score를 겹치면 상담은 많은데 점수가 낮은 토픽이 바로 보이고, 그게 고칠 순서가 됩니다. 세 작업이 따로 노는 게 아니라 '무엇을 고칠지'라는 하나의 질문에 답하는 파이프라인이라는 점이 중요해요. 뒤에서 이 셋을 한 모델에 담으려 한 이유도 여기서 이해됩니다.
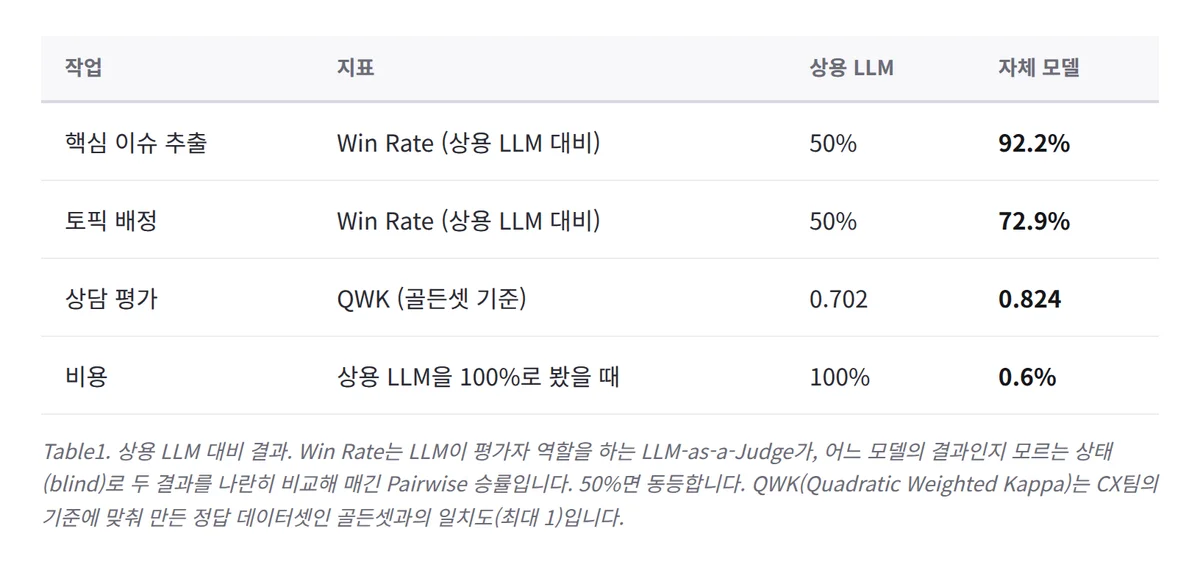
문제는 비용이었습니다. 모든 고객사의 모든 상담, 긴 대화, 상담당 세 작업, 오르는 API 가격. 결과는 비용 99.4% 절감, 연간 약 6억 원입니다. 이 숫자의 분모를 밝혀 둔 점은 정직합니다. 99.4%는 전환 전후 한 주의 상용 LLM API 비용을 실측해 비교한 값이고, 6억 원은 자체 GPU 비용을 뺀 주간 순절감액을 1년으로 환산한 보수적 추정이라고 적었어요. 다만 이 계산에 학습에 들어간 엔지니어의 시간, 데이터를 만든 CX팀의 시간은 들어 있지 않습니다. 첫해의 진짜 절감액은 그보다 작을 거고, 둘째 해부터 커질 겁니다.
전환 조건을 걸 수 있었던 이유
팀에는 오픈 모델을 직접 학습하고 운영해 본 경험이 없었고, "프론티어 모델 대비 자체 모델이 정말 이점이 있나"를 계속 의심했다고 합니다. 그래서 전환 조건을 비용이 아니라 '세 작업 모두 상용 LLM보다 좋을 것'으로 걸었어요. 상담 분석 결과가 품질 관리와 운영 의사결정에 쓰이니 싸다는 이유만으로 바꿀 수 없다는 판단이었습니다.
이 조건은 말로는 쉽지만, 세 작업 모두 정답이 하나로 정해지지 않는 문제라 처음엔 채점조차 할 수 없었습니다. 무엇이 좋은 핵심 이슈이고 좋은 토픽인가. 여기서 팀이 한 일이 이 글의 본체라고 저는 봅니다. CX팀과 함께 기준을 항목 단위로 쪼개 Rubric을 만들었고, 좋은 핵심 이슈를 '자연스러운 문장'이 아니라 '토픽으로 묶기 좋은 문장'으로 정의했습니다. "택배 언제 와요? 너무 늦네요ㅠ"보다 "배송 지연 문의"가 낫다는 식이죠. 다음 단계에 쓸모 있는가로 앞 단계의 품질을 정의한 겁니다.
그리고 CX팀 기준에 맞춘 약 1만 2천 건의 골든셋을 만들어 학습 데이터와 완전히 떼어 두고, 모델이 정말 좋아졌는지 확인하는 데만 썼습니다. 지표도 작업마다 골랐어요. 정답이 여럿일 수 있는 이슈 추출과 토픽 배정은 상용 LLM의 결과와 나란히 놓고 비교하는 Win Rate로, 등급이 있는 상담 평가는 한 칸 틀린 것과 네 칸 틀린 것을 다르게 보는 QWK로. Win Rate의 심판(Judge)은 선생 모델이나 비교 대상과 다른 계열의 모델을 써서, 자기 계열의 답을 더 좋게 보는 Self-preference Bias를 막았고요.
QWK를 계산할 때 판단 근거가 없는 neutral을 5단계의 가운데인 3점으로 둔 선택은 따져 볼 만합니다. 모르는 걸 '보통'으로 치면 점수가 가운데로 끌려가는 효과가 생기니까요. 다만 최종 CX Score에서는 neutral 항목을 아예 빼고 계산한다고 했으니, 평가 지표와 서비스 점수에서 neutral을 다르게 다룬다는 점을 이해하고 읽으면 됩니다. 데이터 쪽 난관도 있었습니다. 어떤 상담은 매우 길고, 여러 상담을 한 프롬프트에 넣어 한 번에 답하게 하는 Batch Prompting도 쓰고, 고객사마다 업종과 자주 나오는 토픽이 달라 학습 데이터를 어떻게 정의할지부터 쉽지 않았다고 해요. 그래서 모든 작업을 한 번에 옮기지 않고 트래픽이 가장 많아 투자 대비 효과가 큰 세 작업부터 시작했다는 순서 선택도 현명했습니다.
저는 LLM 기반 기능을 운영하는 팀 대부분이 여기서 막힌다고 봅니다. 프롬프트를 고치고 모델을 바꿀 때마다 "좋아진 것 같다"는 감으로 배포하고, 학습과 평가에 같은 데이터를 섞고, 평가를 같은 계열 모델에 맡깁니다. 그러면 비교 대상보다 낫다는 결론은 언제든 나오지만 아무도 그걸 믿지 못하죠. 채널톡이 걸 수 있었던 전환 조건은 결국 이 인프라의 다른 이름입니다.
작게 만들며 더 잘하게 만든 세 개의 벽
평가가 생기자 진짜 어려운 문제가 남았습니다. 작게 만들면서 상용 LLM보다 잘하게 만드는 것.
첫 번째 벽은 증류의 역설이었습니다. 프론티어 모델을 선생으로 두고 그 답을 작은 모델이 따라 배우게 했더니, 만든 데이터를 전부 학습하면 오히려 성능이 떨어졌어요. 선생의 출력 분포와 학생이 실제로 다루는 데이터의 분포가 어긋나는 Distribution Shift였습니다. 팀은 질문을 "어떤 데이터가 학생에게 학습 가치가 있나"로 바꾸고 많은 실험을 했다고만 적었는데, 구체적인 선별 기준이 빠진 건 아쉽습니다. 이 대목이 다른 팀이 가장 많이 헤맬 자리거든요.
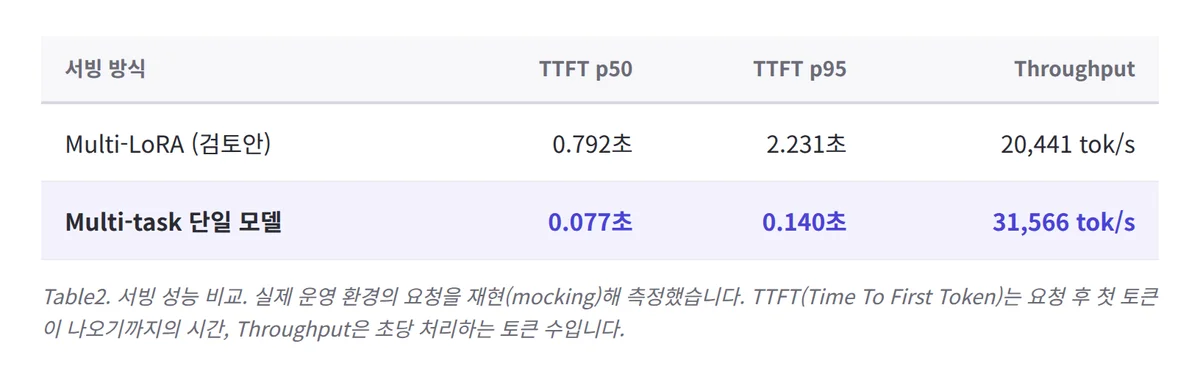
두 번째 벽은 세 작업을 한 모델에 담는 일이었습니다. 작업마다 따로 학습하면 성능이 좋았고, 작업별 LoRA adapter를 한 서버에서 바꿔 끼우는 Multi-LoRA도 고려했지만 실측해 보니 요청마다 다른 adapter를 적용하는 비용 때문에 큐가 쌓였습니다. 하나의 모델로 처리하면 TTFT가 약 10배(p95 기준 약 16배) 빨라지고 처리량은 54.4% 늘고 인스턴스는 절반으로 줄었어요.
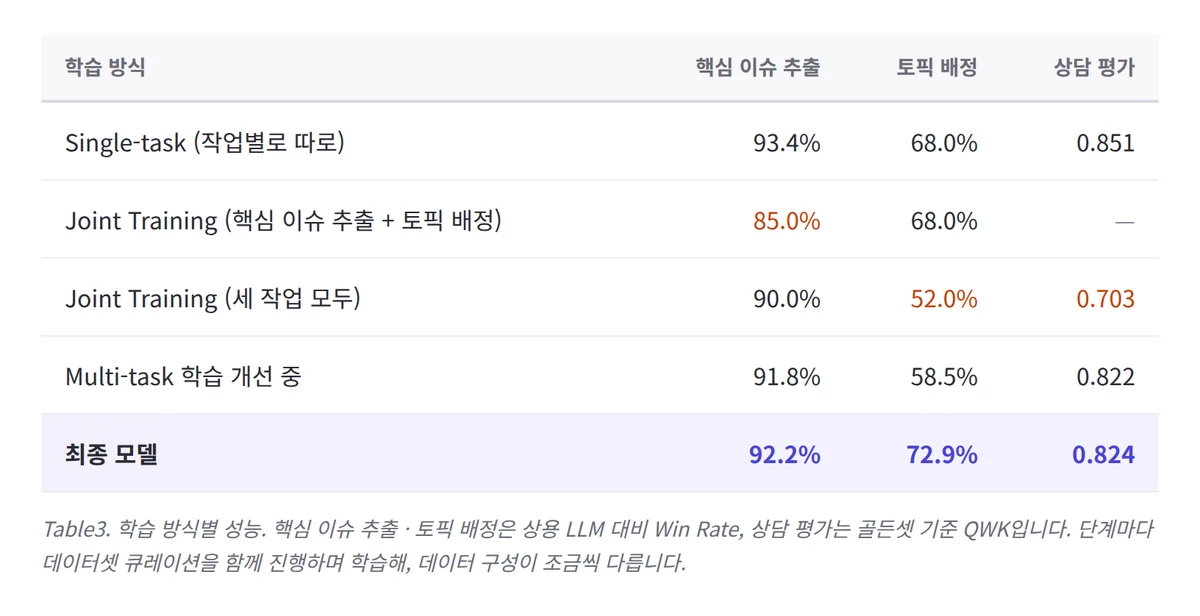
그런데 세 작업 데이터를 그냥 섞어 학습하자 성능이 무너졌습니다. 두 작업만 합쳐도 핵심 이슈 추출이 93.4%에서 85%로 떨어졌고, 셋을 다 합치자 토픽 배정 52%, 상담 평가 0.703까지 내려갔습니다. 상용 LLM과 비기는 수준인 50%, 0.702로 돌아간 셈이라 전환 조건을 못 지킬 뻔했죠. 출력 모양도 목표도 다른 작업들이 모델을 서로 다른 방향으로 끌어당기는 Gradient Conflict로 봤고, 여러 번의 실험 끝에 이슈 추출과 상담 평가는 단일 작업 모델에 가까운 성능을 되찾았고 토픽 배정은 오히려 단일 작업(68%)을 넘는 72.9%까지 올랐습니다.
세 번째 벽은 토픽 배정에서 학습할 때마다 새로 맞히는 케이스와 원래 맞히던 걸 틀리는 케이스가 동시에 생기는 현상이었습니다. 전체 점수만 보면 안 보이는 문제죠. 저는 이것도 평가 인프라 덕에 보였다고 생각합니다. 골든셋이 있으니 건별로 이전 모델과 비교할 수 있었고, 그래야 '평균은 올랐는데 단골 고객의 단골 질문을 틀리기 시작했다' 같은 사고를 배포 전에 잡을 수 있습니다.
숫자 밖에서 드러난 차이
처음의 neutral 사건으로 돌아가 보면, 팀이 분석한 사례 두 개가 이 프로젝트의 성격을 잘 보여 줍니다. 하나는 보험 상담입니다. 상담이 Rubric이 정한 단계, 즉 전자청약 링크 전송과 체결 지원까지 가지 않았는데, 자체 모델은 판단할 근거가 없다며 neutral을 줬고 상용 LLM은 그 행동이 없었다는 이유로 negative를 줬습니다. 다른 하나는 응답 시간입니다. Rubric은 3분 이내 응답을 요구하지만 모델 입력에는 시간 정보가 아예 없습니다. 자체 모델은 판단할 수 없다며 neutral을, 상용 LLM은 "지체 없이 응대했다"며 positive를 줬어요.
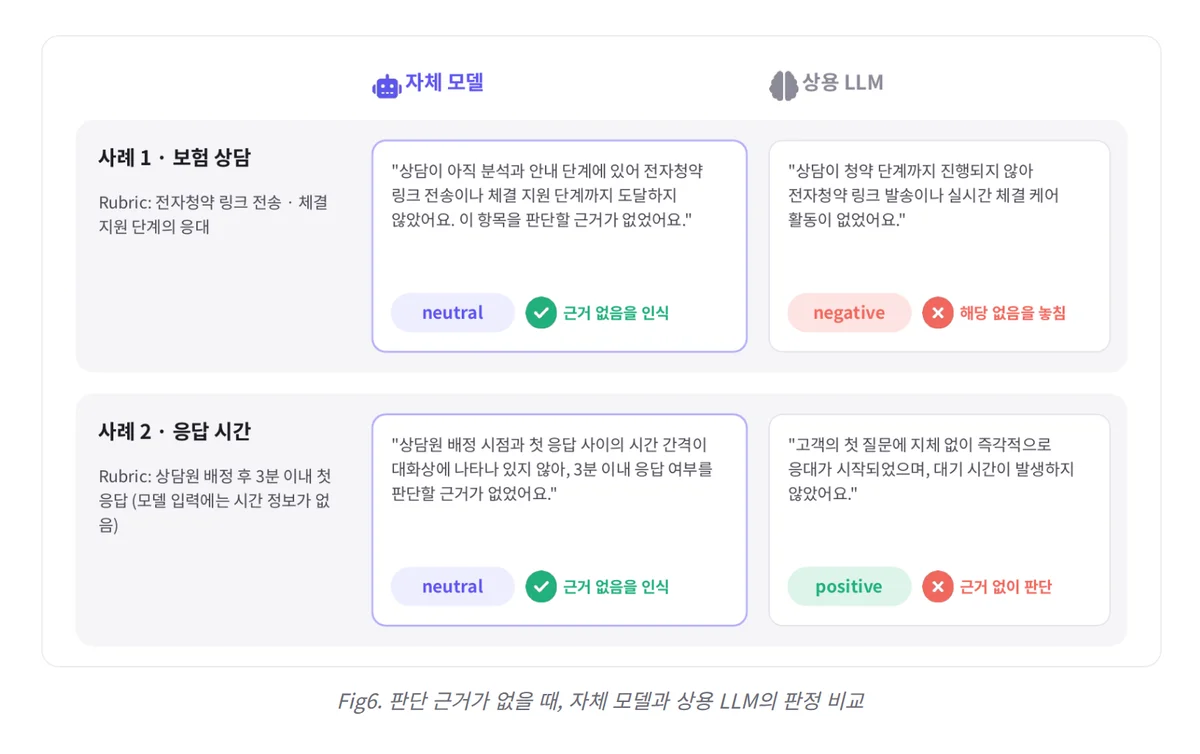
두 번째 사례는 특히 서늘합니다. 상용 LLM이 확인할 수 없는 정보를 있다고 가정하고 고객사에 좋은 점수를 줘 왔다는 뜻이니까요. 큰 모델이 '그럴듯한 답'을 내는 습관이 평가 업무에서는 가장 위험한 습관이 됩니다. 이 차이를 발견할 수 있었던 건 Rubric이 '근거가 없으면 neutral'을 명시해 뒀기 때문이고, 그 규칙을 학습 데이터와 골든셋이 일관되게 담았기 때문입니다. 다만 고객사 입장에서는 어느 날 점수 분포가 바뀐 셈이라, 이런 변화를 어떻게 설명했는지가 궁금합니다. 평가 모델을 바꾸는 일은 측정 도구를 바꾸는 일이라, 이전 점수와의 연속성을 고객에게 설명하는 비용도 전환 비용에 넣어야 합니다.
고정비로 바뀐 비용, 누구에게 맞나
글의 마지막 관찰은 비용 구조의 변화입니다. 상용 LLM은 상담이 늘어나는 만큼 비용이 그대로 늘지만, 자체 모델은 GPU라는 고정비로 돌아가고 서빙 최적화와 오토스케일링으로 장비 몇 대만 더하면 늘어나는 상담을 감당한다는 것. 상담이 많아질수록 이점이 커지는 구조입니다.
저는 이 대목에 조건을 붙이고 싶습니다. 고정비 전환은 물량이 확실하고 꾸준히 늘어나는 회사에게 유리한 베팅입니다. 채널톡처럼 모든 고객사의 모든 상담을 읽는 회사라면 맞는 선택이에요. 반대로 물량이 들쭉날쭉하거나 아직 작다면, 고정비는 놀고 있는 GPU가 됩니다. 그리고 운영 부담이 남습니다. 팀도 실제 데이터 분포가 바뀌어 성능이 떨어지거나 특정 실패 사례가 쌓이는 시점을 판단할 재학습 기준(Retraining Trigger)과 학습-평가-배포 자동화를 만드는 중이라고 했어요. 상용 LLM을 쓸 땐 모델 개선이 공급자의 일이었지만, 이제는 그게 팀의 일이 됐습니다. 상용 LLM의 다음 버전이 나왔을 때 Win Rate 우위가 그대로일지도 지켜봐야 할 숫자고요.
이 사례를 따라 하려는 팀에게 저는 순서를 이렇게 권하겠습니다. 상용 LLM으로 돌리는 작업 중 트래픽이 가장 많은 것 하나를 고르고, 모델을 학습하기 전에 그 작업의 Rubric과 학습에서 떼어 둔 골든셋부터 만드세요. 그리고 전환 조건을 숫자로 적어 두세요. 이 셋이 없는 상태에서 작은 모델을 학습하는 건 비용 절감이 아니라 품질을 건 도박입니다. 반대로 이 셋을 갖췄다면, 모델을 자체로 바꾸지 않더라도 이미 상용 LLM을 더 잘 쓰는 팀이 돼 있을 겁니다.