TopK 배분은 배낭 문제보다 줄 세우기에 가깝다
후보를 4분의 1로 줄였는데 전환율이 올라갔다면, 그동안 잘려 나간 4분의 3은 무슨 일을 하고 있었던 걸까요? 토스 쇼핑 추천팀이 홈 피드에서 돌린 실험 중에는 모든 리트리벌 모델의 TopK를 일괄 1/4로 깎은 실험군이 있었습니다. 결과는 User CVR +8.89%, Order PU +10.52%. 이번 실험에서 목표 지표가 가장 높았던 안이 바로 이 무식한 축소였습니다.
글에서는 이 결과가 더 정교한 해법을 고른 배경 정도로 지나가는데, 저는 이 숫자부터 붙잡고 싶어요. "후보는 넉넉히 넘기고 랭커가 알아서 고르면 된다"는 추천 시스템의 흔한 믿음이, 적어도 이 시스템에서는 틀렸다는 증거거든요.
랭커는 공짜 거름망이 아니다
후보가 많으면 좋은 상품을 놓칠 확률은 줄어듭니다. 대신 비용이 붙죠. Ranking 단계가 점수를 매길 상품이 늘고, 광고 상품은 유효성 검사를 한 번 더 거쳐야 하고, 피드를 만드는 시간이 길어져 응답이 늦어집니다. 덜 눈에 띄는 비용도 있어요. 점수가 낮은 후보가 뒤 단계까지 살아남을 가능성이 커진다는 점입니다. 랭커의 예측이 완벽하지 않은 이상, 후보 풀이 커질수록 랭커가 실수할 기회도 같이 커질 수밖에요.
그럼 이 비대함은 누가 만들었을까요. TopK는 각 모델을 맡은 ML Engineer가 경험으로 정해 왔습니다. 구매 이력 모델이 500개, 최근 클릭 모델이 200개를 가져오면 합은 700개. 모델 하나하나만 보면 합리적인 값이었을 겁니다. 문제는 합에 주인이 없었다는 데 있습니다. 새 리트리벌 모델이 생길 때마다 후보 수는 조금씩 늘었고, "전체 700개가 적당한가"를 자기 일로 여긴 사람은 없었던 거죠.
테크리드 자리에서 보면 이건 모델링 문제이기 전에 소유권 문제입니다. 설정값이 여러 사람의 몫을 더한 합으로 정해지는 곳이라면, 타임아웃이든 재시도 횟수든 커넥션 풀이든 같은 일이 벌어지거든요.
진짜 재료는 한계 가치 곡선
팀이 문제를 다시 쓴 방식은 단순합니다. 모든 모델의 TopK를 똑같이 줄이지 말고, 전체 후보 수라는 예산 안에서 가치가 높은 모델에 더 많이 배정하자. 그러려면 "이 모델에서 후보를 하나 더 가져오면 얼마짜리인가"를 알아야 하죠.
그 값을 추측으로 정하지 않았다는 점이 이 글에서 가장 탄탄한 대목입니다. 실제 추천 로그를 사용자·피드·리트리벌 모델별로 모으고, Ranking 단계의 랭커로 각 상품의 pCTR과 pCVR을 배치 계산한 뒤, 모델과 순위별로 평균을 냈습니다. 가치로는 pICVR, 즉 pCTR × pCVR을 썼고요. 노출된 뒤 구매까지 이어질 확률입니다.
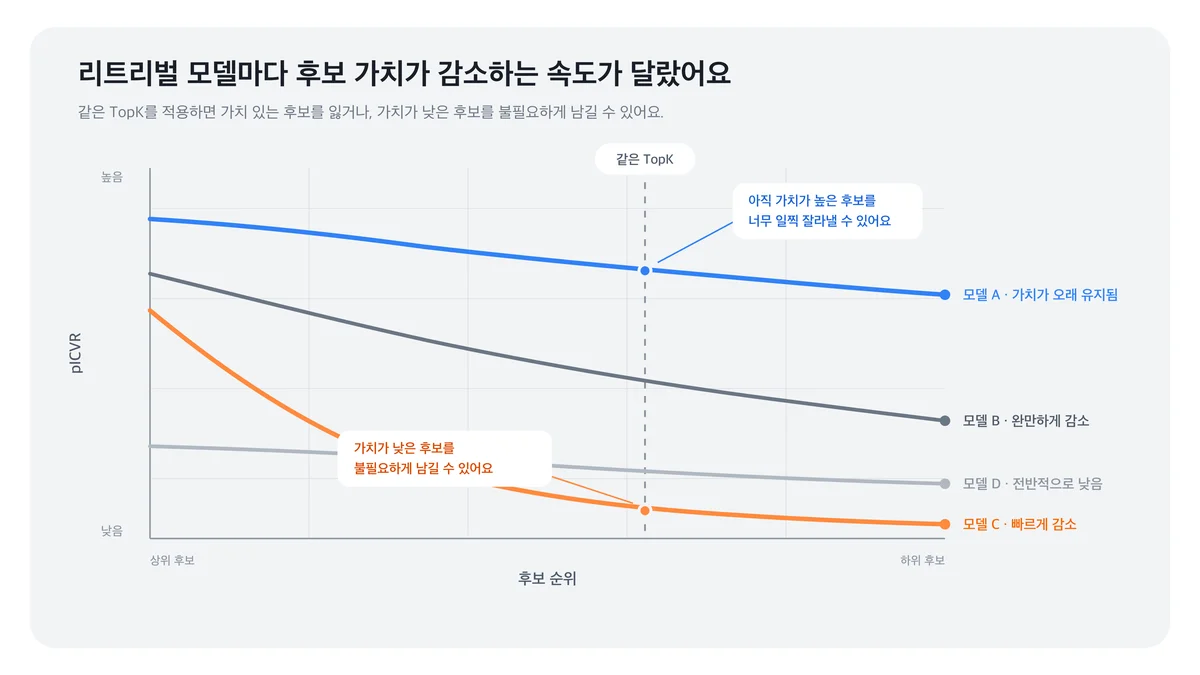
맨 위 그래프가 그 결과를 개념적으로 보여 줍니다. 어떤 모델은 하위 순위까지 가치가 완만하게 유지되고, 어떤 모델은 상위 몇십 개를 지나면 곤두박질칩니다. 시뮬레이션에서도 기존 TopK를 그대로 두는 편이 나은 모델이 있었고, 25%나 10% 수준까지 줄여도 목적 함수가 거의 움직이지 않는 모델도 있었습니다.
모든 모델을 50%씩 자르는 방식이 왜 손해인지가 여기서 보입니다. 곡선이 평평한 모델에서는 아직 비싼 후보를 버리고, 가파른 모델에서는 이미 값이 떨어진 후보를 붙들게 되니까요.
무게가 전부 1인 배낭
팀은 이 배분을 배낭 문제(Knapsack Problem)에 빗대고 정수계획법(Integer Programming)으로 풉니다. 10kg 배낭에 9kg짜리 100점 물건 하나보다 5kg짜리 60점 물건 둘을 넣는 편이 낫듯, 가치 높은 것부터 담는 탐욕법은 최적 조합을 놓칠 수 있다는 설명이죠.
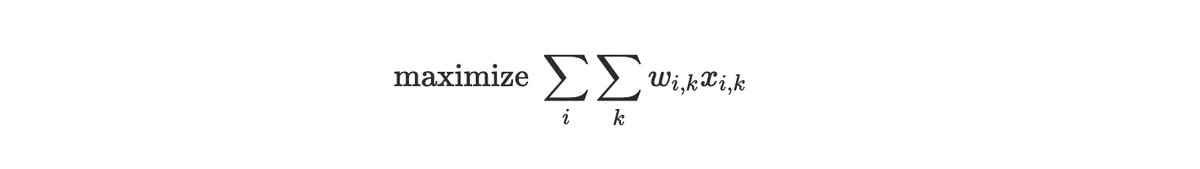
x_{i,k}는 모델 i의 k번째 상품을 고르면 1, 아니면 0이고, 목적은 고른 상품의 w_{i,k} 합을 최대로 만드는 것입니다. 제약은 셋. 전체 TopK 합은 기존의 약 50% 이하, 모델별 최소 후보 수 보장, 그리고 100번째를 고르려면 1번째부터 99번째까지도 골라야 한다는 순서 조건.
여기서 저는 비유가 살짝 과하다고 봐요. 배낭 문제가 까다로운 건 물건마다 무게가 달라서입니다. 그런데 이 제약식의 예산은 "후보 수의 합" 하나뿐이라 모든 후보의 무게가 똑같이 1이죠. 무게가 같으면 9kg 대 5kg 같은 함정은 생기지 않습니다. 가치 곡선이 순위를 따라 내려가기만 한다면, 문제는 모든 모델의 (모델, 순위) 칸을 가치순으로 한 줄에 세우고 예산만큼 자르는 일로 바뀝니다. 모델별 최소 수량을 먼저 채우고, 남은 예산은 한계 가치가 가장 큰 칸부터 하나씩 내주면 끝이에요.
```python import heapq
alloc = {m: min_k[m] for m in models} budget = total_budget - sum(alloc.values()) heap = [(-value[m][alloc[m]], m) for m in models if alloc[m] < len(value[m])] heapq.heapify(heap) while budget > 0 and heap: _, m = heapq.heappop(heap) alloc[m] += 1 budget -= 1 if alloc[m] < len(value[m]): heapq.heappush(heap, (-value[m][alloc[m]], m)) ```
곡선이 단조 감소하면 이렇게 뽑아도 순서 조건은 저절로 지켜집니다. 정수계획법이 제값을 하는 건 로그 평균으로 만든 곡선이 중간에 튀어 오르거나, 모델별 상한·하한 같은 운영 규칙이 쌓일 때입니다. 광고처럼 하나당 검증 비용이 다른 후보가 섞여 무게가 1이 아니게 되면 그때는 정말 배낭 문제가 되고요. 솔버를 들일지는 그 조건으로 판단하면 됩니다. 이 프로젝트에서 결과를 가른 건 솔버의 정교함보다 곡선의 정확도였다고 저는 읽었습니다.
위너를 고른 건 균형 감각일까, 규칙일까
온라인 실험은 7일 동안 다섯 갈래로 돌았습니다. 비교군, 일괄 1/2 축소, 일괄 1/4 축소, 정수계획법, 그리고 상품 커버리지를 넓히도록 배정한 Maximum Coverage. 목표 지표는 User CVR(User Conversion Rate)과 Order PU, 보조 지표는 ICVR·CVR·CTR·GPU, 가드레일은 RPU였고, 위너를 고르는 규칙은 결과를 보기 전에 정해 뒀습니다.
정수계획법 실험군은 후보를 약 절반만 쓰면서 이렇게 움직였습니다.
| 지표 | 비교군 대비 | | --- | --- | | User CVR | +7.552% | | Order PU | +10.133% | | ICVR | +9.286% | | CVR | +13.496% | | GPU | +11.218% | | RPU | +0.832% | | CTR | -3.710% |
User CVR과 Order PU의 p-value는 0.0001보다 작았습니다. 목표 지표만 보면 일괄 1/4이 더 높았지만, 그 안은 RPU가 3.98%, AOV(Average Order Value)가 5.73% 빠졌어요. 주문 수는 늘었는데 싼 상품 쪽으로 구매가 쏠렸을 가능성이 큽니다. Maximum Coverage는 RPU를 2.05% 올려 수익성은 지켰지만 목표 지표 개선 폭이 작았고요.
팀은 정수계획법을 고른 이유를 "가장 높은 숫자보다 균형 잡힌 결과"로 설명합니다. 저는 조금 다르게 봅니다. 일괄 1/4은 가드레일인 RPU를 깨뜨린 안이라, 미리 정한 규칙대로라면 애초에 위너가 될 수 없었습니다. 균형 감각이 이긴 게 아니라 결과 전에 적어 둔 규칙이 이긴 셈이죠. 다른 팀이 이 글에서 그대로 가져갈 만한 건 정수계획법보다 이 습관이라고 생각합니다. 숫자를 본 뒤에 기준을 정했다면 +8.89%의 유혹을 이기기 어려웠을 테니까요.
아쉬운 빈칸도 하나 있습니다. 이 프로젝트의 출발점은 비용이었습니다. 랭커가 평가할 상품, 광고 유효성 검사량, 피드를 만드는 시간이 불어나는 게 문제였죠. 그런데 결과 보고에는 전환 지표만 있고, 후보를 절반으로 줄여 랭킹 연산과 응답 시간이 얼마나 가벼워졌는지는 나오지 않습니다. 인프라 비용까지 같이 책임지는 팀이라면 그 숫자가 전환율만큼 궁금할 겁니다. 전환이 오른 건 보너스였고, 원래 받으려던 성적표는 아직 공개되지 않은 셈이죠.
무엇을 가치라고 부를 것인가
절반으로 줄인 대가도 글은 감추지 않습니다. 정수계획법 실험군의 CTR은 3.71% 떨어졌고, 사용자당 고유 노출 상품 수는 22.07% 줄었습니다. 클릭 기회는 줄고 남은 클릭이 구매로 이어지는 효율은 올라간, 많이 보여주기에서 살 만한 것만 남기기로의 이동입니다.
팀도 이 해석에 인과를 단정하지 않았는데, 맞는 태도라고 봐요. CVR은 구매 수를 클릭 수로 나눈 값이라, 확신 없이 눌러 보던 클릭이 빠지기만 해도 상품 구성과 상관없이 올라갑니다. 그래서 이 실험에서 제가 더 믿는 숫자는 CVR +13.496%가 아니라 분모가 사용자인 User CVR과 Order PU 쪽입니다.
다양성 손실은 목적 함수에서 이미 예고돼 있었다고 봐요. 가치를 pICVR 하나로 정의하고 그 합을 최대화하면, 자주 높은 점수를 받는 상품이 반복해서 뽑히는 건 자연스러운 귀결입니다. 여러 리트리벌 모델이 같은 인기 상품을 함께 가져오는 경우라면, 단순 합산에서는 그 상품이 모델마다 따로 점수를 얻는 셈이라 쏠림이 더 커질 수 있고요(이 부분은 실험으로 확인된 사실이 아니라 제 추론입니다). Maximum Coverage라는 실험군을 따로 둔 것 자체가 팀도 이 위험을 알고 있었다는 방증일 겁니다.
후속 실험에서는 TopK를 그대로 두고 Gumbel Weighted Sampling을 붙여, 목표 지표를 유의하게 떨어뜨리지 않으면서 피드 중복도를 평균 11.25% 낮추고 노출 다양성을 4.61% 높였습니다. RPU도 2.30% 올랐습니다. 좋은 수습이지만, 따라 하는 팀이라면 순서를 바꾸길 권해요. 다양성 지표를 첫 실험의 가드레일에 넣어 두면 22.07%짜리 손실을 사후에 발견할 일이 없으니까요.
랭커가 랭커의 입력을 정할 때
하나 더 짚고 싶은 건 순환입니다. 이 방식에서 후보의 가치는 랭커가 예측한 pCTR·pCVR로 계산되고, 그 가치가 다시 랭커에게 넘어갈 후보의 몫을 정합니다. 랭커가 과소평가하는 종류의 상품을 잘 찾아오는 리트리벌 모델이 있다면, 그 모델은 예산을 잃고, 그 상품들은 노출 기회를 잃고, 랭커는 그 상품들에 대해 배울 데이터를 잃습니다. 팀이 다음 과제로 꼽은 신규 모델의 로그 부족, 그래서 필요하다는 Shadow Logging도 같은 뿌리에서 나온 문제로 보입니다.
다음 단계로는 최근 로그를 반영해 주기적으로 다시 계산하는 동적 Global K와, 사용자의 이력량·최근성에 따라 배분을 바꾸는 개인화 TopK가 검토되고 있습니다. 순서는 앞의 것이 먼저여야 한다고 생각해요. 개인화는 배정 단위를 사용자로 쪼개는 만큼, 예측 오차도 사용자 단위로 키우니까요.
이 접근이 먹히는 조건은 분명합니다. 리트리벌 모델이 여러 개고, 각자 다른 사람이 TopK를 정해 왔고, 랭커 예측을 순위별로 집계할 로그가 쌓인 팀이라면 당장 해볼 만합니다. 그때 첫 실험에는 일괄 축소 실험군을 꼭 끼워 넣으세요. 일괄 축소가 이긴다면 그건 최적화가 필요하다는 신호이기 전에, 지금의 후보 풀이 아무도 책임지지 않은 숫자였다는 진단이니까요. 리트리벌 모델이 하나뿐이거나 랭커의 예측을 아직 믿기 어려운 단계라면, 정교한 배분보다 랭커 보정이 먼저입니다.