웹뷰를 깎지 않고 줄을 끊다, 배민 critical-script가 낸 두 번째 입구의 값
웹뷰가 네이티브보다 느리다는 말이 나오면 대개 두 군데를 의심합니다. 번들이 무겁거나 API가 느리거나. 그래서 번들을 쪼개고, API 응답을 깎고, preconnect로 서버와 미리 연결해 둡니다. 배민 커머스 웹뷰 팀도 그 셋을 이미 다 해 둔 상태였습니다. 그런데도 B마트 가게홈 웹뷰는 좋은 기기, 좋은 Wi-Fi에서도 네이티브 화면보다 굼떴죠. 다 깎았는데 왜 느릴까요?
왜 이 화면에 그렇게 공을 들였는지는 짚고 갈 만합니다. 가게홈은 장보기 서비스에서 사용자가 가장 많이 들어오는 첫 진입 화면이고, 웹뷰는 iOS와 Android를 한 번에 만들고 스토어 심사 없이 배포하는 대신 매번 HTML·CSS·JavaScript를 내려받아야 하는 값을 치릅니다. 로딩이 늘어지면 이탈이 늘고, 이탈은 주문 전환으로 이어지죠. 팀이 근거로 든 Vodafone의 2021년 A/B 테스트에서는 LCP를 31% 줄인 페이지가 매출 약 8%, 장바구니 진입 11% 증가를 냈습니다. 커머스 첫 화면에서 수백 ms는 엔지니어의 자존심이 아니라 매출 문제라는 뜻입니다.
이 사례가 좋은 건 거기서 "더 깎자"로 가지 않았다는 점입니다. 남은 문제가 각 단계의 무게가 아니라 단계들이 서 있는 순서라는 걸 알아챘거든요. 저는 이 글을 인라인 스크립트 기법보다 '번들이 코드의 유일한 입구'라는 관성을 깬 이야기로 읽는 편이 더 쓸모 있다고 봅니다. 그리고 입구를 하나 더 내면 반드시 따라오는 비용이 있는데, 팀이 정작 공들여 푼 건 그쪽이었습니다.
다 깎았는데 왜 느린가
Chrome DevTools Performance 탭으로 본 가게홈의 로딩은 한 줄로 서 있었습니다. index.html을 받아 파싱하고, script 태그의 번들을 받고, 번들을 실행해 React 트리를 만들고, 그제야 API를 부르고, 응답이 오면 다시 렌더링합니다. 빌드된 에셋을 정적 파일로 배포하는 구조라 서버가 HTML에 데이터를 채워 주는 SSR 단계도 없었고요.
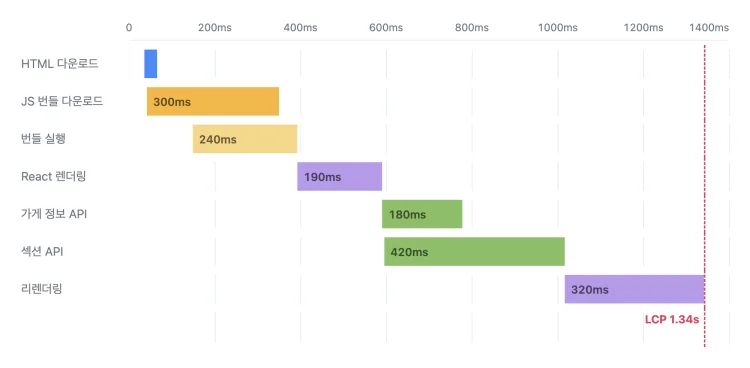
각 단계가 앞 단계가 끝나야 시작하니 LCP는 단계별 소요 시간을 그냥 더한 값이 됩니다. 이 구조에서 단계 하나를 10% 줄이면 전체도 대략 그 몫만큼 줄어듭니다. 이미 충분히 다듬은 단계라면 사용자가 느낄 만한 차이는 나지 않고, 다음 분기에 비즈니스 로직이 붙으면 그 이득은 금세 사라지죠.
진짜 질문은 따로 있었습니다. API 요청이 정말 번들 실행을 기다려야 하는가. 가게홈이 부를 API 주소는 페이지 URL만 보면 알 수 있습니다. React가 그 주소를 계산해 내는 게 아니라, 번들이 실행돼야 요청 코드가 돌 뿐이에요. 서로 의존하지 않는 두 일이 한 줄에 서 있었던 겁니다. 문제를 이렇게 다시 세우면 할 일이 '깎기'에서 '줄 끊기'로 바뀝니다.
개발자에게 익숙한 말로 바꾸면 임계 경로 문제입니다. 첫 화면이 그려지기까지 반드시 거쳐야 하는 의존 사슬이 있고, 전체 시간은 그 사슬의 길이로 정해집니다. 사슬을 줄이는 방법은 둘뿐이죠. 고리 하나하나를 짧게 만들거나, 사슬에 매달릴 이유가 없는 고리를 떼어 옆으로 빼거나. CI에서 순차로 돌던 린트와 테스트를 병렬 잡으로 나누는 것과 같은 발상인데, 프런트엔드에서는 이상하게 이 질문을 덜 합니다. 번들 하나가 모든 코드를 품고 시작하는 구조가 너무 당연해서, 번들 바깥에서 코드를 돌릴 생각 자체를 잘 안 하거든요.
HTML 안에 두 번째 입구를 낸다
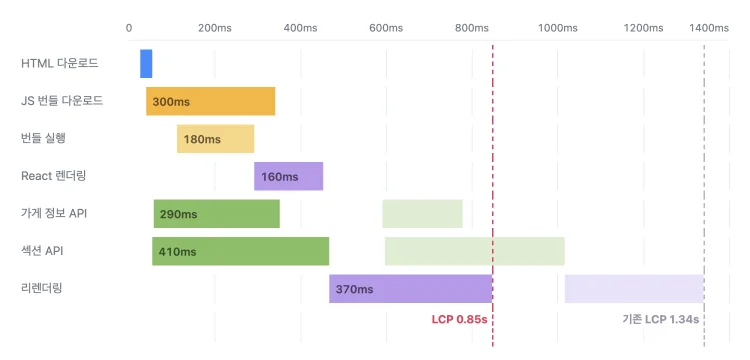
해법 자체는 단순합니다. HTML에 인라인 스크립트를 넣어, 브라우저가 HTML을 파싱하는 순간 fetch를 보내 버리는 것. 그러면 번들 다운로드·실행과 API 왕복이 나란히 진행됩니다. 첫 실험에서 갤럭시 S22+, Wi-Fi 조건의 LCP가 1,340ms에서 847ms로 37% 줄었습니다. 위 썸네일이 그 전후 워터폴인데, API 막대가 번들 막대 옆으로 끌려 올라온 게 보입니다.
여기까지는 누구나 떠올릴 수 있는 아이디어입니다. 재미있는 건 다음 단계예요. 인라인 스크립트가 받은 응답을 메인 앱이 써야 하는데, 둘은 서로 다른 런타임이라 모듈 스코프를 공유하지 못합니다. 그래서 팀은 window에 전역 캐시를 두고 요청 URL을 키로 응답 Promise를 넣었습니다. 메인 앱의 axios request interceptor는 요청을 보내기 전에 이 캐시를 먼저 열어 보고, 있으면 꺼내 쓰고 지웁니다. 인라인 쪽은 코드를 작게 유지하려 axios 대신 fetch를 썼으니, fetch 응답을 axios 응답 모양으로 바꾸는 adapter까지 붙였고요.
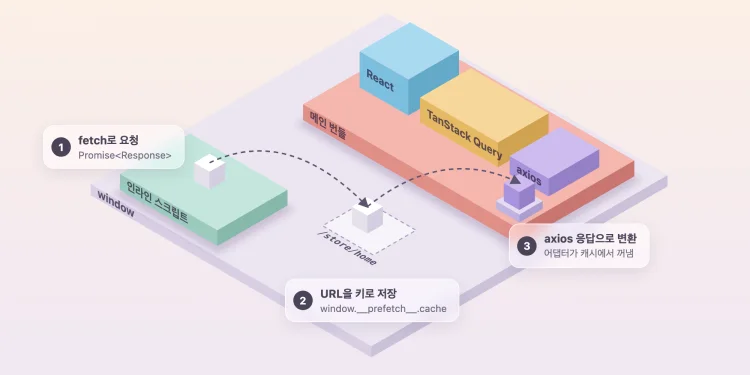
제가 이 글에서 가장 오래 본 장면이 이 그림입니다. 입구가 둘이 되는 순간 둘 사이에 약속이 생깁니다. 인라인 스크립트와 메인 앱은 같은 URL 문자열을 만들어야 하고, 같은 전역 이름을 써야 하고, 응답 모양에 합의해야 하죠. 어느 하나가 어긋나도 에러는 나지 않습니다. interceptor가 캐시를 못 찾으면 평소처럼 요청을 한 번 더 보낼 뿐이거든요. 성능 개선은 조용히 사라지고, API는 두 번 불리고, 아무도 모릅니다. 이 기법의 진짜 난이도는 fetch를 앞당기는 데가 아니라 이 약속을 지키는 데 있습니다.
2차 시도가 고친 건 성능이 아니었다
사실 약속 문제는 1차 구현 때부터 보였습니다. 손으로 쓴 인라인 스크립트에는 컴파일 타임 타입 검사가 없어서, API 스펙이 바뀌면 인라인 쪽만 낡은 주소나 파라미터로 요청을 보내게 됩니다. 팀은 그래서 API 호출 코드도 비즈니스 로직인 만큼 최소한 TypeScript로 쓰고 빌드해야 한다고 판단했고, 요구사항을 셋으로 정리했습니다. 인증 정보 같은 공통 정보까지 직접 가져와 API를 부를 수 있을 것, 결과물이 HTML 크기를 불리지 않도록 작을 것, 최종 HTML에 인라인으로 들어갈 것. 당시 가게홈은 Next.js였고, Next.js는 인라인 스크립트를 문자열로만 받았습니다. 그래서 모노레포에 전용 패키지를 만들어 Vite로 미리 빌드하고, 페이지에서는 webpack raw-loader로 결과물을 문자열로 읽어 Script 컴포넌트(beforeInteractive)에 넣었죠.
1차 구현은 LCP를 줄였지만 팀은 곧바로 아쉬운 점 세 가지를 꼽았습니다. 인라인 스크립트가 별도 패키지에서 Vite로 미리 빌드돼 페이지 코드와 멀리 떨어져 있었고, 그래서 메인 앱의 API 타입이나 URL 유틸을 가져다 쓰지 못해 같은 상수를 두 벌로 관리해야 했고, 페이지 하나에 적용하려면 빌드 엔트리를 하나씩 추가해야 했다는 것. 셋 다 결국 '약속이 깨지기 쉬운 구조'라는 같은 말입니다. URL을 조합하는 함수가 두 벌이면 언젠가 반드시 달라지니까요.
2차 시도는 CSS Modules와 vanilla-extract에서 착안했습니다. 페이지 옆에 StoreHomePage.critical.ts를 두고, 페이지에서는 `?as-critical-script`를 붙여 import합니다.
```tsx import CriticalScript from './StoreHomePage.critical?as-critical-script'
export default function Page() { return ( <> <CriticalScript /> <StoreHomePage /> </> ) } ```
Vite 플러그인은 이 import를 만나면 모듈 로딩 단계에서 해당 파일을 esbuild로 iife 번들·압축하고, 그 코드를 script 태그로 렌더링하는 React 컴포넌트로 바꿔 돌려줍니다. 빌드 타임에 페이지를 프리렌더링하면 이 컴포넌트가 HTML head에 인라인 스크립트로 박힙니다. 스타일 파일을 TypeScript 모듈처럼 import하되 빌드는 플러그인이 따로 처리하는 방식을 스크립트에 그대로 옮긴 셈이죠.
번들러를 조금 아는 분이라면 훅을 건 위치가 눈에 들어올 겁니다. 번들러는 import를 만나면 먼저 모듈 해석 단계에서 경로를 실제 파일로 바꾸고, 이어서 모듈 로딩 단계에서 그 파일의 코드를 읽습니다. 플러그인은 로딩 단계에서 모듈 지정자 끝의 `?as-critical-script`만 보고 원본 코드 대신 다른 코드를 내놓습니다. 페이지 입장에서는 평범한 컴포넌트를 import한 것뿐이라 빌드 설정을 건드릴 일이 없고, 새 페이지에 적용할 때도 파일 하나를 만들고 import 한 줄을 쓰면 끝납니다. 1차 구현에서 페이지마다 빌드 엔트리를 추가하던 수고가 여기서 사라졌습니다.
이 설계에서 핵심은 인라인 스크립트가 메인 앱과 같은 프로젝트 안에서 빌드된다는 점입니다. getStoreHomeUrl 같은 URL 함수를 인라인 스크립트도 그대로 import하니, 앞에서 말한 약속 중 가장 깨지기 쉬운 'URL 문자열 일치'가 코드 한 벌로 묶입니다. 저는 이게 37%보다 큰 성과라고 봅니다. 기법이 가게홈 한 페이지에서 약 80개 페이지로 퍼진 이유도 여기 있을 거고요. 퍼지는 기술과 한 페이지에 머무는 기술을 가르는 건 대개 성능 수치가 아니라 두 번째 사람이 쓰기 쉬운가입니다.
8KB 상한도 같은 맥락에서 읽힙니다. 압축 결과가 outputSizeLimit(기본 8KB)를 넘으면 빌드가 실패합니다. 처음엔 4KB로 걸었다가 가끔 넘쳐서 8KB로 올렸다는데, 의도한 로직만 담으면 8KB 안에 넉넉히 들어가고 라이브러리를 실수로 import하면 확실히 넘는다는 계산이에요. 이 숫자는 성능 예산이 아니라 실수 감지기입니다. 메인 앱의 모듈을 import할 수 있게 문을 열어 준 순간 axios 같은 의존성이 딸려 들어올 위험도 같이 열렸는데, 팀은 그 문을 크기로 지켰습니다. 문을 열면서 같은 자리에 경비를 세운 설계라 저는 이 대목을 높이 삽니다.
같은 입구로 들어온 다른 일들
입구가 생기자 쓰임새도 넓어졌습니다. 가장 먼저 붙은 건 LCP 이미지 preload입니다. 많은 페이지에서 LCP 요소는 상단 배너나 앞쪽 상품 이미지인데, 그 URL은 API 응답 안에 있습니다. API 요청을 앞당겨도 이미지 요청은 여전히 React가 img 태그를 그린 뒤에야 시작되니, 줄이 한 칸 더 남아 있던 셈이죠. 그래서 인라인 스크립트가 응답 JSON을 직접 열어 배너·로고 URL을 꺼내고 link rel="preload"를 head에 붙입니다. 여기서 눈여겨볼 디테일이 `res.clone()`이에요. 응답 본문은 한 번 읽으면 다시 읽을 수 없으니, 인라인 쪽은 복제본을 읽고 원본은 메인 앱 몫으로 캐시에 남겨 둡니다. 두 런타임 사이 약속이 또 하나 늘어난 장면이고, 누가 이 줄을 무심코 지우면 메인 앱이 빈 본문을 받게 됩니다.
디바이스 인셋도 비슷합니다. 배민 웹뷰는 상단 바·상태 표시줄·홈 인디케이터를 피해 그려야 하고, 그 크기는 앱 브리지를 비동기로 호출해야 얻습니다. 인라인 스크립트가 번들보다 먼저 브리지를 불러 값을 CSS 변수로 넣고, HTML에 박힌 스켈레톤은 값이 들어올 때까지 visibility로 숨겨 둡니다. 엉뚱한 자리에 그렸다 옮기는 것보다 잠깐 늦게 제자리에 그리는 쪽을 고른 거죠. 저는 이 선택이 맞다고 보지만, 브리지 응답이 늦어지는 기기에서는 스켈레톤조차 안 보이는 시간이 생긴다는 점은 함께 재야 합니다. 상품 목록 카드가 이미 보여 주던 이미지 URL을 쿼리 파라미터로 넘겨 상세 페이지 첫 페인트에 바로 쓰는 것, 배경색을 먼저 칠해 흰 화면 깜빡임을 줄이는 것도 같은 입구를 씁니다.
공통점은 하나입니다. 모두 '번들이 실행돼야만 알 수 있는 게 아닌데 번들을 기다리던 일'이라는 것. 이 기법이 SSR 환경에서도 쓸모 있다는 설명도 같은 원리로 이해됩니다. 서버는 디바이스 인셋이나 로컬 스토리지 값을 모르니, 첫 페인트 전에 클라이언트에서만 얻을 수 있는 값을 처리할 입구는 여전히 필요하죠. 반대로 API가 이미 충분히 빨라도 효과가 남는 이유는, 줄이는 대상이 API 처리 시간이 아니라 번들 실행 뒤에 시작되던 네트워크 왕복이기 때문입니다.
30%의 분모, 그리고 재지 않은 것
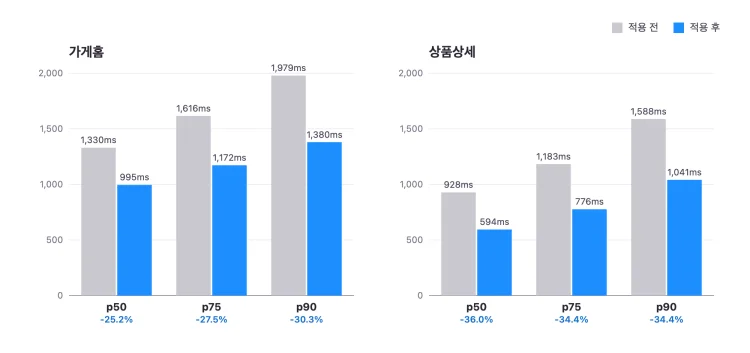
운영 결과는 Sentry 실사용자 데이터로 적용 전후 각 1주일을, 사용자가 가장 많은 기기 하나로 집계했습니다. 가게홈과 상품상세 모두 p50·p75·p90에서 25~35% 개선됐어요. 제목의 30%는 이 범위의 가운데쯤입니다.
FCP 쪽 측정은 커머스홈에서 했습니다. 스켈레톤을 HTML에 프리렌더링해 두더라도 인셋을 적용하는 코드가 번들 안에 있으면 결국 번들 다운로드와 실행을 기다려야 했는데, 그 코드를 critical-script로 옮기자 스켈레톤이 곧바로 뜨면서 FCP가 크게 줄었다는 설명입니다. LCP 개선이 '데이터를 일찍 받는 일'이라면 FCP 개선은 '보여 줄 수 있는 걸 일찍 보여 주는 일'이고, 같은 입구가 두 가지 모두에 쓰였다는 점이 이 기법의 범용성을 보여 줍니다.
기기를 하나로 고정한 건 편차를 줄이려는 정직한 선택입니다. 다만 그만큼 이 숫자는 '가장 흔한 기기'의 숫자예요. 지연이 불안정한 모바일 망에서 효과가 더 크다는 설명은 있지만, 저사양 기기나 나쁜 망 구간의 데이터는 따로 없습니다. 효과가 더 클 수도 있고, 인라인 스크립트 실행이 HTML 파싱 중의 메인 스레드를 잡아 손해를 볼 수도 있습니다. 저는 그 구간은 재 봐야 안다고 봅니다.
더 궁금한 건 글에 아예 없는 숫자입니다. 80개 페이지에서 전역 캐시 적중률이 얼마인지, 프리페치 응답이 에러일 때 메인 앱이 그 에러를 그대로 받는지 다시 요청하는지, 인증 정보가 만료된 상태에서 인라인 스크립트가 어떻게 행동하는지. 앞에서 말했듯 이 기법의 실패는 대부분 조용합니다. 키가 어긋나면 이중 요청이 되고, 에러가 섞이면 메인 앱의 재시도 로직이 우회될 수 있는데, 둘 다 LCP 대시보드에는 잡히지 않아요.
한계를 숨긴 글은 아닙니다. 파이프라인을 병렬로 펼 뿐 CPU 시간과 네트워크 시간 자체를 줄이지 않는다는 점, 인라인 스크립트는 React·TanStack Query·polyfill이 없는 별도 런타임이라 최소 지원 브라우저의 기능만 써야 한다는 점, 그래서 crypto 라이브러리를 Web Crypto API로 갈아 끼우고 axios는 대체 비용이 커서 어댑터로 버텼다는 점까지 적혀 있습니다. 이 정도로 솔직한 팀이면 계측도 내부에선 하고 있으리라 짐작하지만, 글만 보고 따라 하는 팀은 그 계측을 직접 만들어야 합니다.
우리 웹뷰에 들일지 가르는 질문
이 기법이 잘 맞는 팀은 조건이 꽤 분명합니다. 정적으로 배포되는 CSR 웹뷰이고, 첫 화면 API의 주소가 페이지 URL만으로 결정되고, 번들이 무거워 실행까지 시간이 걸리는 곳. 반대로 첫 API가 로그인 상태나 앱 설정처럼 런타임에 비동기로 얻는 값에 기대는 팀이라면 인라인 스크립트가 해 줄 수 있는 일이 줄어듭니다. 그 비동기 호출까지 인라인으로 끌어내리면 이번엔 그 코드가 8KB 안에 들어가느냐가 새 문제가 되고요.
도입한다면 저는 순서를 이렇게 잡겠습니다. 먼저 Performance 탭 워터폴에서 '의존 관계가 없는데 앞 단계를 기다리는 요청'에 표시를 해 봅니다. 그런 요청이 한두 개라면 인라인 fetch 하나로 실험하고, 효과가 확인되면 URL 생성 함수를 공유할 수 있도록 페이지 옆으로 옮기고, 마지막으로 캐시 적중률과 이중 요청 수를 계측합니다. 번들러 플러그인부터 만들면 약속은 깔끔해지지만 그 약속이 실제로 지켜지는지는 여전히 모릅니다. 그리고 인라인 스크립트에는 메인 앱의 polyfill이 적용되지 않으니, 첫 줄을 쓰기 전에 서비스가 지원하는 가장 오래된 웹뷰 버전에서 어떤 ECMAScript 문법과 Web API가 도는지 목록부터 만들어 두는 게 좋습니다. 옵셔널 체이닝 하나가 구형 기기에서 첫 화면 전체를 멈춰 세울 수 있는 자리니까요.
배민 팀이 이름을 inline-script가 아니라 critical-script로 지은 이유가 저는 마음에 듭니다. 인라인에 담는 게 목적이 아니라 임계 경로를 줄이는 게 목적이라는 거죠. 그 이름값을 하려면 "무엇을 인라인에 넣을까"보다 "무엇이 줄을 설 이유가 없는가"를 먼저 물어야 하고, 이미 다 깎아서 더 깎을 게 없는 팀일수록 그 질문에서 남는 게 많을 겁니다.