코딩 에이전트를 매일 오래 쓰는 팀이라면, 기본값부터 재 보세요
이 설정을 따라 하려는 팀이 먼저 물어야 할 건 "몇 토큰을 아끼나"가 아니라 "무엇을 잃나"입니다. 이 글에 공유된 설정은 Claude Code의 기본 토큰을 37.1k에서 10.9k로, 약 71% 줄였습니다. 숫자는 시원하지만, 그 안에는 플랜 모드를 여닫는 도구와 사용자에게 되묻는 도구까지 꺼 버리는 선택이 들어 있어요. 토큰을 덜 쓰는 에이전트는 행동도 달라진 에이전트입니다.
그렇다고 이 글을 흘려들을 일은 아닙니다. 기본값도 비용이라는 관점, 그리고 그 비용을 /context 한 줄로 직접 재 보라는 제안은 코딩 에이전트를 매일 쓰는 팀이라면 오늘 해 볼 가치가 있어요. 제 판단을 미리 말하면 이렇습니다. 이 정리로 확실히 얻는 건 돈보다 긴 세션에서의 여유 공간이고, 진짜 배울 점은 71%라는 숫자가 아니라 '기본값은 남이 바꾸는 설정'이라는 사실입니다.
설치만 해도 실리는 37.1k
새 세션을 열고 /context를 쳤더니, 메시지를 하나도 안 보냈는데 46.8k 토큰이 잡혀 있었습니다. 자기가 쓴 지침 파일이나 skill 탓인가 싶어 설치 직후 상태를 확인해 보니 그때도 이미 37.1k였고, 그중 27.2k가 도구 정의(System tools)였습니다.
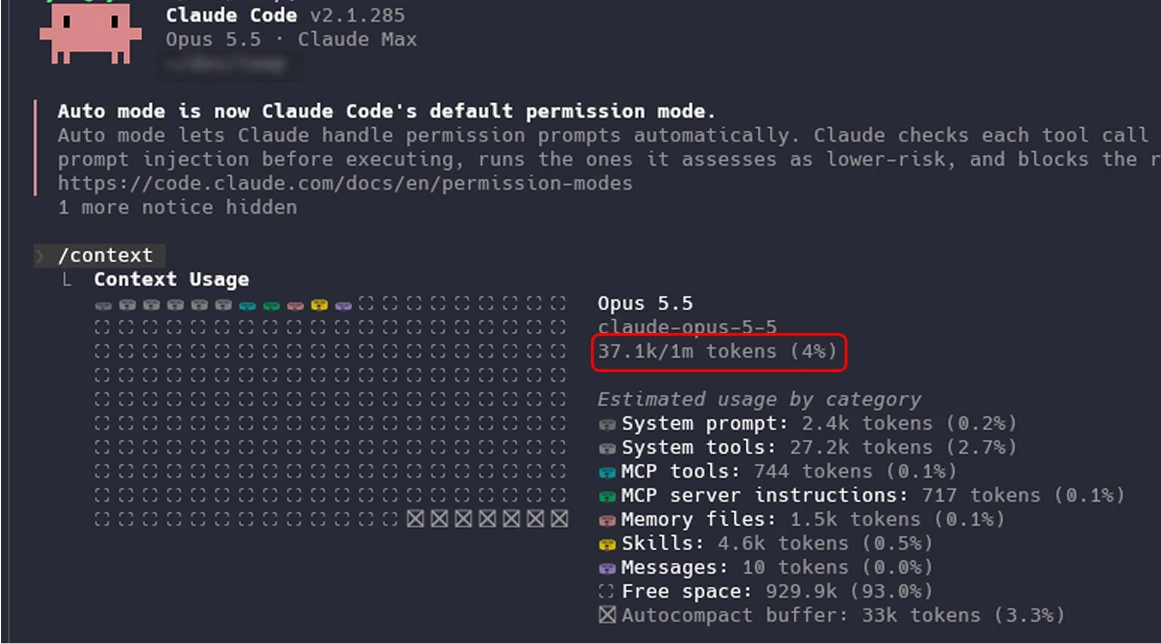
이유는 단순합니다. Claude Code 같은 에이전트는 LLM을 호출하고 도구 실행을 처리하는 하네스 위에서 돌고, 그 하네스에는 개발사가 넣어 둔 system prompt와 도구 정의가 들어 있습니다. 개발사는 모든 사용자를 염두에 두니 기능을 넓게 담고, 그 설명은 내가 쓰든 안 쓰든 매 요청에 실립니다. 설치 직후 MCP 목록에는 Claude Docs 문서 도구 3개가 744 토큰을 차지하고 있었고, 연결한 적 없는 Gmail·Google Calendar·Google Drive 도구도 대기 중이었습니다. Jupyter 노트북을 편집하는 NotebookEdit 같은 도구는 노트북을 안 쓰는 사람에겐 그냥 짐이고요. 누군가에게는 유용한 기능이지만 나에게도 필요한지는 직접 판단해야 한다는 말이 이 글의 출발점입니다. 범용 도구의 기본값은 평균적인 사용자를 위한 것이고, 평균적인 사용자는 실제로 존재하지 않으니까요.
LLM은 이전 대화를 기억하지 못하니 에이전트는 매 요청마다 지금까지의 대화를 통째로 다시 보내고, 기본 토큰은 그 맨 앞에 매번 붙습니다. 여기까지가 글이 세운 문제입니다. 저는 이 진단에 동의합니다. 다만 그 문제가 얼마나 아픈지를 따질 때 글이 든 근거 두 개, 비용과 성능은 조금 나눠서 볼 필요가 있다고 봐요.
비용과 성능, 근거의 거리를 재 보면
먼저 비용입니다. 매 요청의 앞부분이 똑같이 반복되니 prompt caching이 붙고, Anthropic API 기준으로 캐시에서 읽은 토큰은 일반 입력 가격의 10%, 스크린샷 속 Opus 5.5는 5%입니다. 글도 이 점을 정직하게 적어 뒀어요. 그렇다면 26k 토큰을 덜어 내서 아끼는 돈은 생각보다 작습니다. 캐시가 자주 깨지는 사용 패턴이 아니라면, 비용만 보고 이 설정을 할 이유는 약하다는 게 제 판단입니다. 거꾸로 캐시의 원리에서 실무 팁 하나는 얻을 수 있습니다. 서버가 재사용하는 건 이전 요청과 똑같은 앞부분이니, 세션 도중에 MCP 서버를 붙였다 뗐다 하거나 지침 파일을 고치면 그 앞부분이 바뀌어 캐시 이득이 사라집니다. 설정 정리는 세션 경계에서, 새 세션을 열 때 하는 게 맞습니다. 그리고 캐시는 돈과 속도만 줄여 줄 뿐, 캐시에서 읽은 토큰도 모델이 실제로 보는 내용이라 컨텍스트 창 사용량에는 그대로 들어갑니다. 비용 논리와 공간 논리를 분리해서 봐야 하는 이유죠.
다음은 성능입니다. 글은 컨텍스트가 길수록 성능이 떨어진다는 근거로 긴 텍스트 속 8쌍의 요청·응답 중 지정한 하나를 찾는 MRCR v2 8-needle 점수를 듭니다. GPT-5.4는 64K~128K 구간 86.0%에서 512K~1M 구간 36.6%로, Claude Opus 4.6은 256K 93.0%에서 1M 76.0%로 떨어졌다는 거죠.
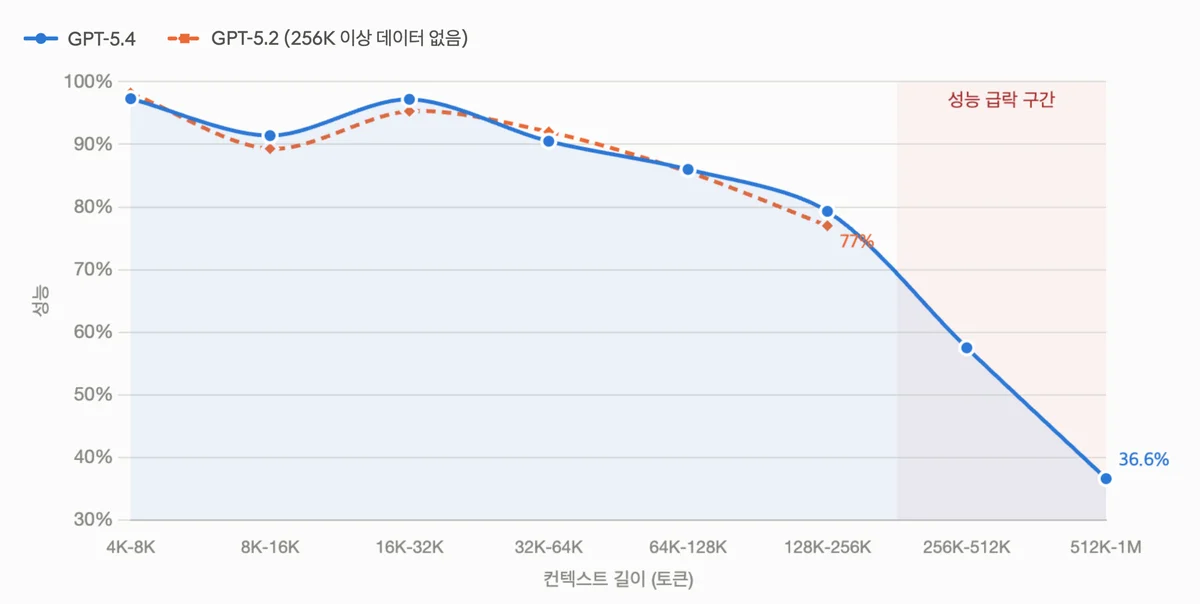
이 그래프는 컨텍스트 부패를 보여 주는 좋은 근거지만, 비교 구간이 수십만에서 백만 토큰 단위입니다. 37k와 11k의 차이, 즉 약 26k 토큰이 이 그래프에서 보이는 하락을 그대로 만든다고 읽으면 과장이에요. 저는 이 대목을 '긴 컨텍스트는 나쁘다'의 근거로는 받되, '기본 도구 몇 개를 끄면 에이전트가 눈에 띄게 똑똑해진다'의 근거로는 받지 않겠습니다.
원리 설명은 깔끔합니다. 모델은 컨텍스트 안의 각 토큰이 다른 모든 토큰과 얼마나 관련 있는지 따져 어디에 주목할지 정하는데, 따져야 할 관계의 수가 토큰 수의 제곱으로 늘어납니다. 토큰이 1천 개면 100만 개, 10만 개면 약 100억 개의 관계가 생기죠. 주목할 대상이 많아질수록 토큰 하나에 돌아가는 주목은 엷어지고, 정작 중요한 지시를 놓치기 쉬워집니다. 이걸 컨텍스트 부패라고 부릅니다. 다만 이 원리에서 나오는 결론은 '총량을 관리하라'이지 '도구 정의부터 지워라'가 아니에요. 도구 정의 26k보다 세션 중간에 붙여 넣은 로그 파일 하나가 훨씬 클 수 있으니까요. 기본 토큰 정리는 총량 관리의 한 항목일 뿐, 긴 로그를 붙여 넣는 습관이나 한 세션에 작업을 몰아넣는 습관이 그대로라면 효과는 금방 묻힙니다. 작업을 한 세션 안에 끝낼 수 있는 크기로 나눠 시작하고, 한계에 가까워지면 새 세션으로 넘기라는 Matt Pocock의 조언이 기본값 정리보다 먼저 와야 할 이유입니다.
그럼 무엇이 남느냐. 글이 함께 인용한 Matt Pocock의 경험적 기준이 실마리입니다. 그는 세션 초반의 에이전트를 Smart Zone, 앞의 지시를 잊고 실수가 늘어나는 구간을 Dumb Zone으로 나누고, 최신 모델에서 Dumb Zone이 대략 125K~150K 무렵부터 시작된다고 봅니다. 본인도 엄밀한 기준이 아니라고 인정하지만, 이 기준을 쓰면 계산이 달라집니다. 37.1k는 그 지점까지의 약 25~30%이고, 10.9k는 10%가 채 안 됩니다. 기본 토큰을 덜어 낸 효과는 '모델이 똑똑해진다'가 아니라 '똑똑한 구간에서 일할 시간이 길어진다'에 가깝다는 얘기죠. 하루 종일 한 세션에서 큰 작업을 굴리는 사람에게는 이게 체감되는 차이고, 짧은 질문만 던지는 사람에게는 거의 의미 없는 차이입니다.
71%는 어디서 나왔고, 대신 무엇을 껐나
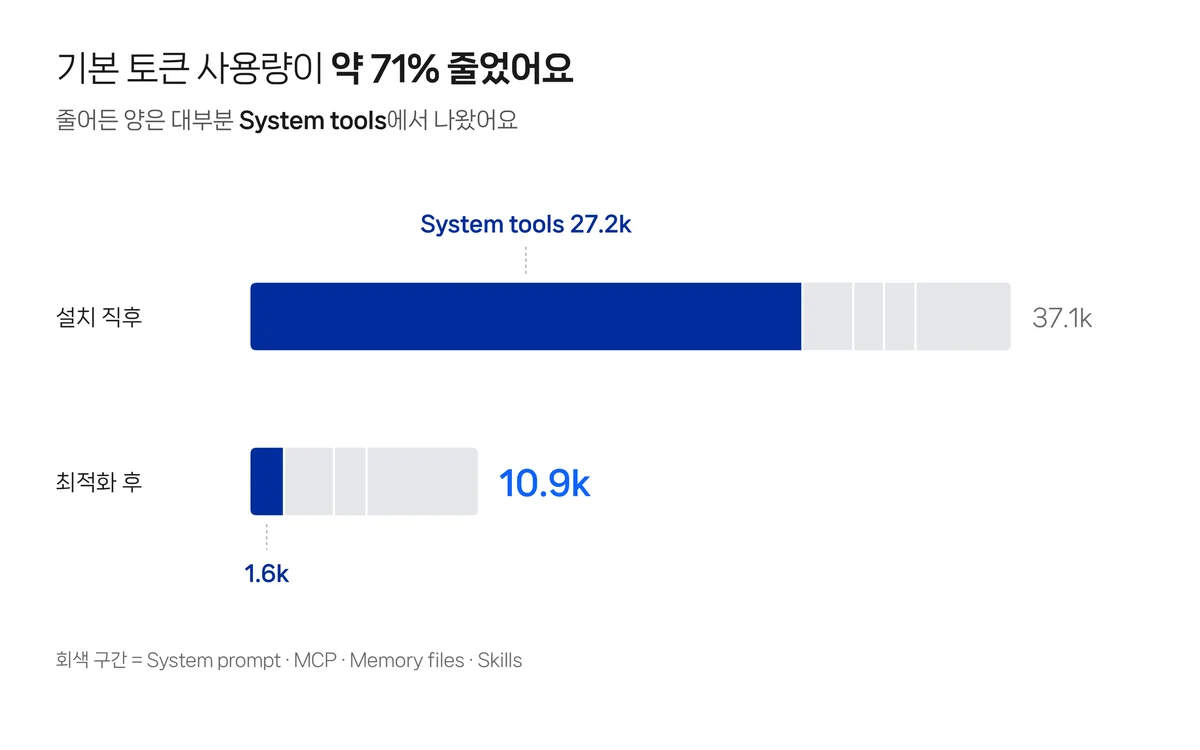
절감 내역을 보면 대부분이 System tools에서 나왔습니다. 27.2k가 1.6k가 됐고, MCP tools 744와 MCP server instructions 717은 아예 사라졌어요. System prompt 2.4k와 Memory files 1.5k는 그대로였고, Skills는 오히려 4.6k에서 5.5k로 늘었는데, 스크린샷을 찍기 전에 skill을 하나 추가한 탓으로 보인다는 단서가 붙어 있습니다. 설정만의 효과는 10.9k보다 조금 더 클 수 있다는 뜻입니다.
설정 자체는 Matt Pocock이 강의 'Killing Bloat' 편에서 공유한 것을 바탕으로 했습니다. settings.json의 deny 목록에 NotebookEdit, DesignSync, Cron 관련 도구, EnterPlanMode와 ExitPlanMode, PushNotification, RemoteTrigger, ReportFindings, ScheduleWakeup, AskUserQuestion을 넣고, claude.ai 커넥터와 워크플로, 번들 skill, 아티팩트를 끕니다. "켜 두면 조금 편해지지만 그보다 잃는 성능이 더 크다"고 판단한 목록입니다.
여기서 제가 조건을 붙이고 싶습니다. 이 목록에는 성격이 다른 두 종류가 섞여 있어요. 하나는 쓰지 않으면 정말 짐인 것들입니다. 연결하지 않은 커넥터, 쓰지 않는 노트북 편집, 쓰지 않는 예약 작업. 이건 끄는 게 맞습니다. 다른 하나는 에이전트의 일하는 방식을 바꾸는 도구들입니다. 플랜 모드를 여닫는 도구를 막으면 계획을 먼저 세우고 승인받는 흐름이 사라지고, 사용자에게 되묻는 도구를 막으면 모호한 지시를 받았을 때 에이전트가 추측으로 밀고 나갈 여지가 커집니다. 토큰은 줄지만 행동이 바뀌는 거죠. 글의 효과 측정은 토큰 수뿐이고, 작업 성공률이나 되돌린 횟수 같은 숫자는 없습니다. 혼자서 자기 방식대로 쓰는 개발자에게는 맞는 설정일 수 있지만, 신입이 많은 팀에 그대로 배포할 설정은 아니라고 봅니다.
글이 토큰 절약 도구에 대해 남긴 경험담은 이 판단과 같은 방향입니다. caveman, ponytail, context-mode, rtk, serena, headroom 같은 도구를 다 써 봤지만 체감할 만큼 줄지도 좋아지지도 않았고, 원본 입출력을 걸러 내는 만큼 잘못 동작하면 에이전트가 의도와 다르게 움직일 수 있어 결국 다 걷어냈습니다. 무언가를 더해서 문제를 푸는 대신 이미 켠 것을 의심하라는 태도에는 저도 전적으로 동의합니다.
기본값은 남이 바꾸는 설정이다
이 글에서 제가 가장 중요하게 본 대목은 사실 숫자가 아니라 버전 얘기입니다. 설정을 하나도 바꾸지 않아도 에이전트 버전이 바뀌면 기본 토큰은 달라집니다. Claude Code를 만든 Boris Cherny는 새 모델이 나올 때마다 system prompt와 도구 정의를 바꾼다고 말했고, 내장 프롬프트를 버전별로 추적하는 Piebald-AI 저장소를 보면 v2.1.288 한 버전에서만 프롬프트 텍스트가 4,051 토큰 늘었습니다.
이 사실이 무서운 이유는 비결정성 때문입니다. LLM은 원래 같은 질문에 매번 같은 답을 내지 않지만, 몇 달 잘 돌던 정기 작업이 어느 날 갑자기 다른 결과를 낸다면 원인은 모델이 아니라 바뀐 기본값일 수 있습니다. 글이 소개한 Mario Zechner의 사례가 그 극단이에요. 그는 릴리스마다 바뀌는 system prompt와 도구 정의, 엉뚱한 위치에 끼어드는 system reminder가 작업 흐름을 깨뜨린다며 Claude Code를 떠나 자기 에이전트 Pi를 직접 만들었습니다. 모든 팀이 그렇게 할 수는 없지만, 기본값이 내 통제 밖에서 움직인다는 감각만은 가져갈 필요가 있습니다.
그래서 저는 이 정리를 '한 번 하는 대청소'가 아니라 '버전마다 재는 계측'으로 바꾸길 권합니다. 에이전트가 업데이트되면 /context를 찍어 이전 숫자와 비교하고, 정기 작업의 결과가 흔들리면 버전 변경 시점부터 의심하는 식으로요. 글이 인용한 Boris Cherny의 습관도 같은 결입니다. 그는 새 모델이 나올 때마다 system prompt를 지우고 한 줄씩 다시 넣어 각 줄의 효과를 확인하는데, 프롬프트가 없을 때 모델이 오히려 조금 더 똑똑했다고 말하고, 사용자에게도 6개월마다 CLAUDE.md와 skill과 hook을 지워 보라고 권합니다.
내 지침 파일은 내가 쌓는 부채
벤더의 기본값이 남의 설정이라면, CLAUDE.md나 AGENTS.md 같은 지침 파일은 내가 쌓는 부채입니다. 이 글의 화면에서 지침 파일이 잡히는 Memory files 항목은 설치 직후 1.5k였는데 실제로는 16.6k였어요. 글은 이 파일에 쌓이는 것을 세 가지로 나눕니다. 지침이 없어도 알아서 하는 일을 굳이 시키는 no-op, 같은 내용이 여기저기 흩어진 중복, 최신 코드와 맞지 않는 옛 정보가 층층이 쌓인 퇴적물. 특정 상황에서만 필요한 내용은 별도 파일로 옮기고 본 파일에는 언제 읽을지만 한 줄로 남기라는 점진적 공개도 권합니다.
이 분류가 좋은 건 코드 리뷰의 언어로 바로 옮겨지기 때문입니다. no-op은 죽은 코드고, 중복은 중복 코드고, 퇴적물은 낡은 주석이에요. 팀이 지침 파일을 저장소에 함께 두고 있다면, 이 셋을 리뷰 체크리스트에 넣는 것만으로도 파일이 불어나는 속도를 꽤 늦출 수 있습니다. 누구나 한 줄씩 더하기는 쉽고 아무도 빼지 않는 파일이니까요.
팀 단위로 보면 하나가 더 걸립니다. 이 글의 설정은 개인 홈 디렉터리의 settings.json에 넣는 방식인데, 팀원마다 끈 도구가 다르면 같은 저장소에서 같은 지시를 줘도 에이전트가 다르게 움직입니다. 누구는 플랜 모드가 있고 누구는 없는 상황에서 "에이전트가 이상하게 동작한다"는 제보가 오면 원인을 찾기가 어렵죠. 저는 행동을 바꾸는 도구의 on/off만큼은 저장소 수준에서 합의해 두고, 개인 설정으로는 연결하지 않은 커넥터 같은 순수한 짐만 덜어 내는 쪽을 권합니다. 지침 파일이 저장소에 있으면서 도구 설정만 사람마다 제각각인 상태가 가장 디버깅하기 어렵습니다.
정리하면 이렇습니다. 코딩 에이전트로 하루에 몇 시간씩 긴 세션을 굴리는 팀이라면 이 글의 방법은 해 볼 만하고, 짧게 묻고 끝내는 팀이라면 비용 이득은 캐시가 이미 대부분 가져갔습니다. 해 본다면 deny 목록을 한 번에 다 넣지 말고, 쓰지 않는 커넥터와 도구부터 끈 뒤 행동을 바꾸는 도구는 하나씩 넣어 보며 평소 작업이 깨지는지 확인하세요. 그리고 무엇보다 /context 숫자를 버전마다 기록해 두는 습관을 들이시길 권합니다. 71%는 오늘의 숫자일 뿐이고, 다음 업데이트가 그 숫자를 조용히 되돌려 놓을 테니까요.