fork한 자식은 부모 객체를 읽기만 하지 않는다 — CPython GC가 쓰는 곳
fork로 만든 자식 프로세스는 부모의 메모리를 복사하지 않고 공유한다. 자식이 무언가를 쓰기 전까지는. 백엔드 개발자라면 대부분 이렇게 배웠고, 그래서 무거운 모듈을 미리 로드해 둔 부모에서 worker를 fork하는 패턴을 메모리 효율적인 설계로 여깁니다. gunicorn의 preload가 대표적이죠.
그런데 이 문장에는 조용한 전제가 하나 숨어 있습니다. '자식이 부모의 객체를 건드리지 않는다면'이라는 전제요. C로 짠 프로그램이라면 맞는 말입니다. CPython에서는 아닙니다. 자식이 부모 객체를 한 번도 읽지 않아도, 인터프리터가 대신 그 객체에 쓰기 때문이에요. 네이버웹툰의 데이터 플랫폼 팀이 Airflow 3을 PoC하며 겪은 두 가지 이상한 증상은 정확히 이 지점에서 나왔습니다. 하나는 메모리가 새는데 메모리 프로파일러에는 아무것도 안 잡히는 증상, 다른 하나는 MySQL 커넥션이 누군가에 의해 정상 종료되는 증상이었습니다.
프로파일러에 안 잡히는 메모리 증가
첫 번째 증상은 worker 메모리였습니다. Airflow 3.1 계열을 CeleryExecutor로 띄워보니 worker 컨테이너 메모리가 시간이 지날수록 늘었습니다. 팀은 같은 fork 재사용 구조를 가진 LocalExecutor부터 조사했어요.
처음 잡힌 건 평범한 문제들이었습니다. 힙 할당을 호출 스택 단위로 보여주는 Memray로 worker를 추적해보니, secrets masker가 타입 확인만을 위해 kubernetes.client 전체를 import하고 있었습니다. worker당 약 32MB, worker 32개면 1GB 가까이 되는 양입니다. Task SDK client가 SSL context를 반복 생성하는 누수도 있어서 worker 하나가 30분 만에 8MB에서 23MB로 늘었고요. 둘 다 이슈로 올려 3.1.2에서 고쳐졌습니다. 팀은 이 과정에서 코드 수정 없이 주요 컴포넌트를 Memray 추적 아래 띄우는 기능과 문서까지 Airflow에 넣었는데, 저는 이런 기여가 버그 수정 못지않게 크다고 봐요. 다음 사람이 같은 조사를 반나절 만에 끝낼 수 있게 되니까요.
진짜 이야기는 그 다음입니다. 두 문제를 고친 뒤에도 메모리는 계속 올랐는데, 이번에는 Memray에 아무것도 잡히지 않았어요. worker가 새로 할당한 메모리는 거의 없는데 사용량은 느는 상황. 팀은 smem으로 프로세스별 PSS와 USS를 봤고, 생성 직후 20~30MB이던 PSS가 서서히 오르다 어느 순간 100MB를 넘어 내려오지 않는 걸 확인했습니다. 1~2시간이면 대부분의 worker가 그 상태에 도달했어요.
여기서 RSS가 거의 변하지 않았다는 게 결정적인 단서입니다. RSS는 프로세스가 물리 메모리에서 건드리는 페이지의 총량이고, PSS는 공유 페이지를 공유하는 프로세스 수로 나눠 더한 값, USS는 그 프로세스만 가진 페이지입니다. RSS가 그대로인데 PSS와 USS만 오른다면, 건드리는 페이지의 양은 같은데 그중 부모와 공유하던 페이지가 자기만의 복사본으로 바뀌고 있다는 뜻이죠. pmap으로 주소 영역별 PSS를 비교하니 부모와 같은 주소를 가진 매핑에서 PSS가 늘고 있었습니다. 자식 쪽에서 어떤 쓰기가 일어나 Copy-on-Write가 발생한 겁니다.
Memray가 이걸 못 본 건 도구의 결함이 아닙니다. Memray는 누가 메모리를 '할당'했는지를 추적하는 도구고, COW는 할당 없이 커널이 페이지를 복사하는 일이에요. 저는 이 대목이 이 글에서 가장 먼저 기억할 실무 교훈이라고 봅니다. fork 기반 서비스의 메모리를 RSS나 할당 추적기로만 보고 있다면, 이 종류의 증가는 원리적으로 보이지 않습니다.
커넥션을 닫은 범인은 자식 프로세스였다
두 번째 증상은 전혀 다른 곳에서 나왔습니다. 메타데이터 DB로 MySQL을 쓰는 환경에서 dag-processor Pod가 불규칙하게 재시작됐어요. 로그에는 (2013, 'Lost connection to server during query') 예외가 남았고, 하필 재시도로 감싸지 않은 지점이라 프로세스가 그대로 죽었습니다.
MySQL general log를 보니 문제 시각에 그 커넥션으로 Quit 명령이 들어와 있었습니다. 서버가 타임아웃으로 끊은 게 아니라 클라이언트 쪽에서 정상 종료 절차를 밟은 거예요. 그런데 dag-processor 메인 프로세스는 그 커넥션을 풀에서 계속 쓰고 있었습니다. 누군가 커넥션을 닫아버렸는데, 쓰는 쪽은 그 사실을 모른 거죠.
팀은 SQLAlchemy Engine의 connect 이벤트에 훅을 걸고 생성된 커넥션 객체에 weakref.finalize를 붙여, 객체가 소멸될 때 로그를 남기게 했습니다. 결과는 명확했어요. 소멸이 일어난 곳은 파싱용으로 fork된 서브 프로세스 PID 417이었고, 소멸 시각은 MySQL 로그의 Quit 시각과 정확히 일치했습니다. mysqlclient 드라이버는 커넥션 객체가 해제될 때 서버에 COM_QUIT을 명시적으로 보냅니다. 부모가 만든 커넥션 객체의 복사본이 자식에서 해제되면서, 부모와 공유하던 소켓으로 종료 신호를 보낸 겁니다.
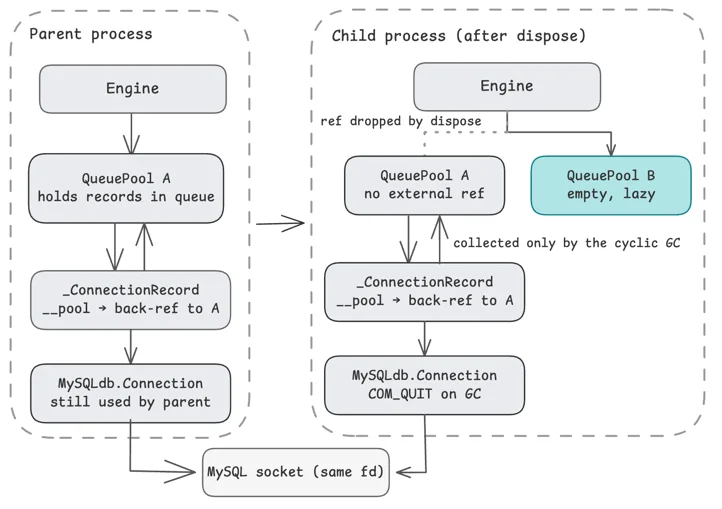
이상한 점은 Airflow가 이미 이 상황을 막아두고 있었다는 겁니다. fork 직후 자식에서 engine.dispose(close=False)를 호출해, 자식이 부모의 커넥션을 건드리지 않고 새 풀을 만들게 하는 처리가 들어가 있어요. SQLAlchemy 문서가 fork와 함께 쓸 때 권장하는 바로 그 방법이고, 그 자체로는 올바른 조치입니다. 그런데 SQLAlchemy의 풀과 커넥션 레코드는 서로를 참조하는 구조라, 참조를 끊어도 참조 카운트만으로는 해제되지 않고 순환 GC가 돌아야 수거됩니다. 그래서 커넥션이 닫히는 시각은 풀을 재생성한 순간이 아니라 자식에서 GC가 임계값에 도달한 순간이었습니다.
이 구조가 재현 조건도 설명합니다. 파싱 서브 프로세스는 대부분 GC 임계값에 닿기 전에 일을 마치고 죽습니다. dynamic DAG generation처럼 파싱이 오래 걸리는 환경에서만 GC가 돌 확률이 높아지고요. 재시작이 잦고 치명적이었는데도 기존 리포트가 없었던 건, 작은 환경에서는 이 버그가 아예 일어나지 않았기 때문입니다. 규모가 커져야만 나타나는 버그는 작은 스테이징에서 영영 안 보인다는 점도 같이 적어둘 만합니다.
읽기만 하는 자식이 쓰는 곳
두 증상의 공통점은 fork로 만들어진 자식이 부모에게서 물려받았지만 자기는 쓰지 않는 객체를 건드리고 있다는 겁니다. 범인은 CPython의 순환 GC예요.
CPython은 메모리를 두 단계로 회수합니다. 1차는 참조 카운트로, 객체를 가리키는 참조가 0이 되는 순간 즉시 해제됩니다. 서로를 가리키는 순환 참조는 바깥에서 아무도 안 써도 카운트가 0이 되지 않으니, 이걸 잡으려고 2차로 순환 GC가 돕니다. 순환 GC는 다른 객체를 담을 수 있는 컨테이너 객체마다 PyGC_Head라는 추가 헤더를 붙여 추적하고, 수집할 때는 각 객체의 참조 카운트를 이 헤더에 gc_refs로 복사한 뒤 추적 객체끼리 주고받는 참조만큼 빼서 외부 참조가 없는 고리를 찾습니다. 추적 객체는 세대 0, 1, 2로 나뉘고, 세대별 카운터가 임계값(기본 700, 10, 10)을 넘으면 수집이 자동으로 시작됩니다. 언제 GC가 돌지는 프로그램이 정하지 않아요.
자식 입장에서 보면 문제가 바로 드러납니다. fork 직후 자식은 부모가 만든 수십만 개의 추적 객체를 그대로 물려받습니다. 자식이 task를 처리하며 새 객체를 만들다 임계값에 닿으면 순환 GC가 돌고, GC는 부모에게서 받은 객체를 포함한 모든 추적 객체의 PyGC_Head에 gc_refs를 기록합니다. 자식이 그 객체를 쓰는지와 상관없이요. 회계 담당자가 장부를 맞추려고 모든 서류에 연필로 체크 표시를 하는 것과 비슷합니다. 서류 내용은 안 바꿔도 종이에는 흔적이 남죠.
커널 쪽에서 무슨 일이 생기는지도 짚고 가겠습니다. fork는 물리 메모리를 복사하지 않고 부모의 페이지 테이블만 복사합니다. 커널은 물리 프레임의 참조 수를 올리고 부모와 자식 양쪽의 PTE를 쓰기 불가로 바꿔요. 이후 어느 쪽이든 쓰기를 시도하면 page fault가 나고, 그 프레임을 둘 이상이 참조하고 있으면 새 프레임에 복사한 뒤 쓴 쪽의 PTE만 갱신합니다. 부모가 원본이고 자식이 사본인 게 아니라, 먼저 쓴 쪽이 복사본을 받습니다.
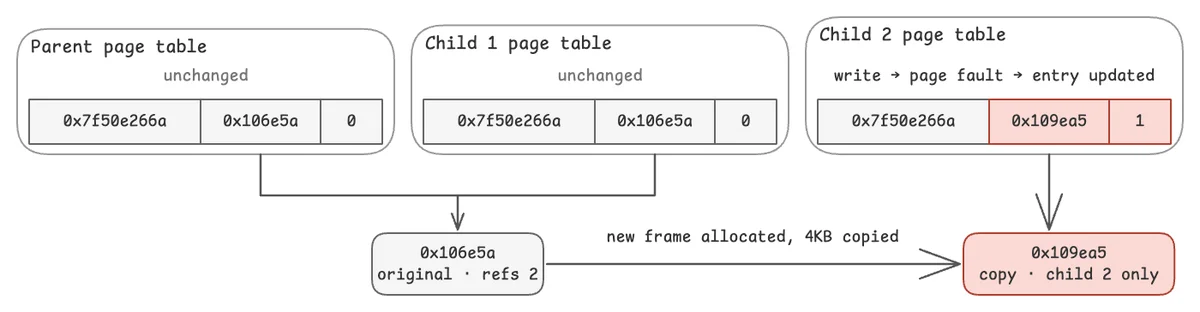
팀은 이걸 실험으로 확인했습니다. 부모가 GC 추적 객체 30만 개를 만들고 서로 다른 페이지에 있는 객체 20개의 주소를 적어둔 뒤 fork합니다. 자식은 /proc/<pid>/pagemap으로 그 페이지들의 물리 프레임 번호를 읽고, gc.collect()를 한 번 호출한 뒤 다시 읽어요. 자식에는 그 객체에 접근하는 코드가 없습니다. 결과는 이랬습니다. 가상 페이지 0x7f83934c3은 fork 직후 부모와 자식 모두 프레임 0x106bcd를 가리켰는데, 자식이 GC를 돌린 뒤에는 자식만 0x107d09로 바뀌었습니다. 수거된 객체는 0개였는데도 20페이지 전부가 복사됐고요.
이 실험 하나로 두 증상이 같은 원인으로 묶입니다. worker 메모리 증가는 순환 GC가 헤더에 쓰면서 생긴 페이지 복사였고, 커넥션 끊김은 같은 GC가 부모의 커넥션 레코드를 쓰레기로 판단해 수거하면서 생긴 부작용이었어요. 저는 이 글의 핵심을 한 줄로 이렇게 정리합니다. CPython에서 fork된 자식은 부모의 객체를 '읽기만' 할 수 없다.
처방은 알려져 있었다, 리듬이 문제였다
원인을 알고 나서 팀이 먼저 시도한 건 자식이 물려받는 객체 자체를 줄이는 방법이었습니다. 스케줄러 루프가 돌기 전에 worker를 먼저 만들고, 많은 모듈을 연쇄로 불러오는 import를 worker 생성 이후로 옮겼어요. 결과는 실패였습니다. Airflow는 컴포넌트를 CLI로 띄우는 순간 패키지 초기화와 함께 SQLAlchemy, FastAPI 같은 라이브러리를 불러와 그것만으로 100MB를 차지했고, 무거운 import를 fork 뒤로 미루자 task마다 그 모듈을 다시 불러와야 해서 1분에 100개 넘게 처리하던 task가 60~70개로 줄었습니다. 메모리를 아끼려고 비용을 hot path로 옮긴 셈이죠.
자식에서 GC를 꺼버리는 gc.disable()도 검토했지만, 그러면 자식이 새로 만든 순환 참조가 수거되지 않아 다른 누수가 생깁니다. 결국 답은 CPython이 3.7부터 제공하는 gc.freeze()였어요. 호출 시점에 GC가 추적하던 모든 객체를 영구 세대로 옮기고 이후 수집에서 무시하는 함수로, Instagram 엔지니어들이 fork 기반 웹 서버에서 똑같은 COW 문제를 겪고 CPython에 기여한 기능입니다. 공식 문서도 "If a process will fork() without exec(), avoiding unnecessary copy-on-write in child processes will maximize memory sharing and reduce overall memory usage."라고 권장하고요. 영구 세대로 간 객체도 참조 카운트로는 여전히 해제될 수 있고, 호출 자체는 리스트를 이어 붙이는 O(1) 작업입니다.
LocalExecutor 적용은 교과서대로였습니다. 부모인 scheduler는 루프를 돌며 객체를 계속 만들고 버리므로 freeze된 채로 둘 수 없어요. 그래서 worker를 띄우기 직전에만 얼렸다가 바로 풉니다.
```python def _spawn_workers(self, n: int): gc.freeze() try: for _ in range(n): self._spawn_worker() finally: gc.unfreeze() ```
자식은 물려받은 객체가 모두 영구 세대에 있는 상태로 시작하니 GC가 그 헤더를 건드리지 않습니다. 부모는 unfreeze 뒤 다시 정상적으로 수집하므로 부모 쪽에서만 COW가 한 번 일어나요. 모든 자식에서 각자 일어나던 복사가 부모의 한 번으로 바뀐 겁니다. freeze와 unfreeze 비용은 각각 19μs, 10μs 정도였고, 이 변경은 PR #58365로 들어가 3.1.4에 백포트됐습니다.
이 글에서 제가 가장 값지다고 보는 건 dag-processor 대목입니다. 같은 freeze/unfreeze 사이클을 적용했더니 이번엔 부모 메모리가 계속 늘었어요. gc.freeze()가 세대 0, 1, 2의 수집 카운터를 모두 0으로 리셋하기 때문입니다. dag-processor는 파일마다 fork를 하니 두 fork 사이에 카운터가 임계값에 닿기 전에 또 0이 되고, 그 사이 부모가 만든 순환 참조 쓰레기는 unfreeze 때마다 세대 2로 옮겨집니다. 세대 2는 full collection만 훑는데, 그 트리거가 계속 리셋되니 영영 오지 않아요. GC가 사실상 꺼진 것과 같은 상태가 된 겁니다.
팀은 freeze 직전에 gc.collect()를 강제하는 방법은 fork마다 full collection을 도는 비용 때문에 버리고, 파싱 루프에 들어가기 직전에 한 번만 freeze하고 unfreeze는 하지 않는 쪽을 택했습니다(PR #60505). 막아야 할 COW는 import airflow와 초기화 과정에서 이미 만들어진 객체들의 것이고, 루프 이후 부모가 만드는 객체는 정상적으로 수거되면 되니까요. CeleryExecutor는 Celery 시그널을 썼습니다. 무거운 모듈의 preload가 끝나는 celery_import_modules 직후 freeze하고, worker 초기화가 끝나는 @worker_ready.connect에서 unfreeze합니다(PR #62212). worker_concurrency 기본값 16개의 ForkPoolWorker는 그 사이에 fork되어 얼어 있는 객체를 물려받아요.
같은 함수인데 세 컴포넌트에 세 가지 방식으로 들어갔습니다. 차이를 가른 건 fork가 얼마나 자주 일어나는가였어요. LocalExecutor처럼 worker가 부족할 때만 가끔 fork하면 freeze/unfreeze를 감싸도 되고, dag-processor처럼 GC 임계값보다 fork가 잦으면 감싸는 순간 GC가 멈춥니다. 저는 이 대목이 gc.freeze를 다룬 다른 글들과 이 글을 가르는 지점이라고 봐요. 처방을 아는 것과 그 처방을 언제 몇 번 쓰는지 아는 건 다른 지식입니다.
숫자로 본 효과와 옮겨 쓸 때 볼 것
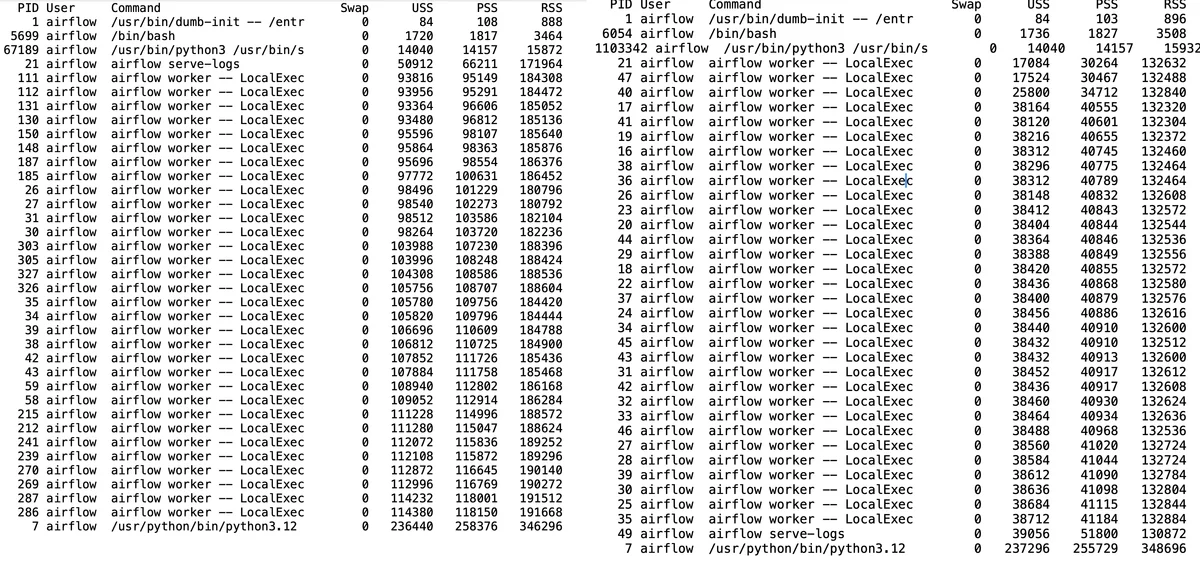
측정 환경은 컴포넌트마다 달라 서로 비교할 수는 없지만, 각각의 변화는 분명했습니다. LocalExecutor는 분당 500개 task를 12시간 돌리는 환경에서 worker가 100MB 이상으로 수렴하던 것이 40MB 수준에서 안정됐고, worker 32개를 띄운 scheduler 컨테이너의 PSS 합계는 약 3.6GB에서 약 1.5GB로 약 2.1GB, 58% 줄었습니다.
dag-processor는 파일당 평균 40개 DAG를 만드는 dynamic DAG 파일 5개를 파싱하는 환경에서 메모리 스파이크가 줄었고, MySQL 커넥션 때문에 Pod가 재시작되던 문제도 사라졌습니다. CeleryExecutor는 worker 컨테이너 하나의 메모리가 2.25GB에서 1.07GB로 줄었고요. 세 변경은 Airflow 3.1.4와 3.1.7, Celery provider 3.17.2에 들어가 있어서 Airflow 3을 운영 중이라면 버전만 올려도 효과를 봅니다.
Airflow를 쓰지 않는 팀이 가져갈 것도 많습니다. gunicorn의 preload처럼 무거운 모듈을 불러온 뒤 fork로 자식을 만드는 Python 서비스라면 같은 패턴이 그대로 나타날 수 있어요. 옮겨 쓰기 전에 저라면 세 가지를 먼저 보겠습니다. 첫째, 메모리 대시보드에 RSS 말고 PSS와 USS가 있는가. 없다면 지금 이 문제가 있는지조차 알 수 없습니다. 둘째, fork가 GC 임계값보다 자주 일어나는가. 그렇다면 freeze/unfreeze를 매번 감싸지 말고 dag-processor처럼 한 번만 얼리는 쪽을 검토해야 합니다. 셋째, 부모 프로세스의 전역에 소멸될 때 부작용을 남기는 자원, 즉 DB 커넥션이나 소켓, 파일 락 같은 게 걸려 있지 않은가. 이번 사례에서 메모리 문제보다 장애가 더 무서웠던 건 이 세 번째 때문이었습니다.
gc.freeze가 만능은 아닙니다. 부모가 fork 전에 만든 객체가 대부분 오래 사는 객체라는 전제가 깔려 있고, 부모에 금방 버려질 순환 참조가 많은 상태에서 얼리면 그만큼의 쓰레기를 자식들이 평생 들고 다닙니다. 반대로 import와 초기화로 만들어진 장수 객체가 대부분인 서비스라면 이보다 싼 처방은 드뭅니다. 결국 이 처방이 맞는 서비스인지는 fork 직전의 부모가 무엇을 들고 있느냐로 판단해야 하고, 그걸 알려주는 건 프로파일러가 아니라 PSS 그래프입니다.