카카오 비전 인코더의 진짜 자산은 성능표가 아니라 족보다
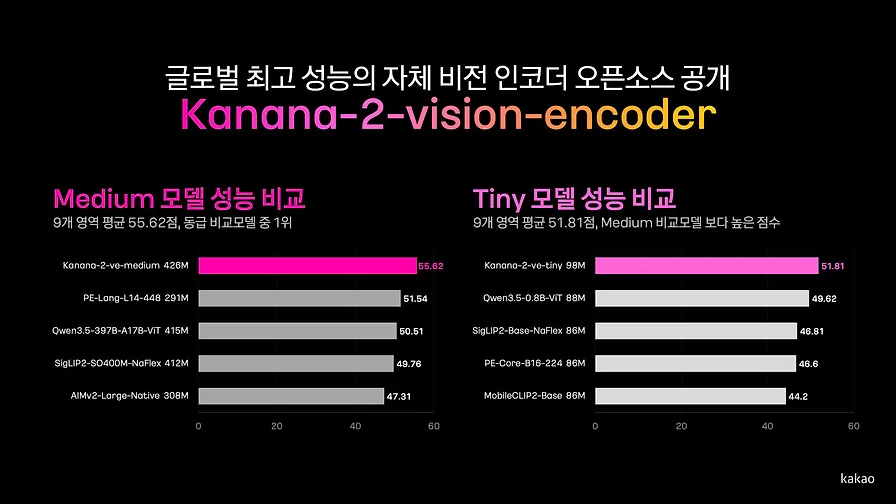
빅테크가 아닌 회사가 비전 인코더를 처음부터 만든다고 하면 첫 반응은 대개 "왜?"입니다. 구글 SigLIP2나 메타 Perception Encoder처럼 가중치에 학습 방법론까지 공개된 인코더가 있는데, 굳이 직접 만들 이유가 있느냐는 거죠. 카카오 Multimodal Model Training팀의 Kanana-2-vision-encoder 개발기는 그 질문에 대한 답이자, 답을 내기 위해 어떤 지름길을 택했는지에 대한 기록입니다.
저는 이 글을 읽으며 성능표보다 출생 기록에 더 오래 머물렀습니다. 이 인코더는 카카오의 언어모델 Kanana-2 LLM의 가중치와 구조를 물려받아 태어났습니다. 학습 효율 4배도, 고해상도 처리 효율도, Large에서 Tiny까지 이어지는 라인업도 대부분 이 한 가지 선택에서 나왔어요. 그리고 같은 이유로 이 인코더의 성적표는 홈그라운드에서 받은 성적표이기도 합니다. 둘 다 알고 읽어야 이 공개를 제대로 쓸 수 있다고 봅니다.
왜 직접 만들었나, 그리고 빅테크의 숫자
먼저 비전 인코더가 무슨 일을 하는지부터 짚겠습니다. 이미지와 함께 "이 이미지 설명해줘"라고 요청하면 이미지는 비전 인코더와 프로젝터를 거쳐 특징으로 바뀌고, 텍스트는 토크나이저와 임베딩을 거쳐, 언어모델이 둘을 함께 받아 답을 씁니다. 비전 인코더는 이 구조의 눈입니다. 메뉴판의 음식과 가격을 읽든 문서의 배치를 파악하든, 여기서 놓친 정보는 뒤에서 아무리 큰 언어모델을 붙여도 되살아나지 않습니다.
카카오가 든 이유는 셋입니다. 비전 언어모델 성능에 가장 큰 영향을 주는 모듈이니 직접 설계해야 개선을 주도할 수 있다는 것, 기존 인코더가 한국 문화와 작은 한글 인식에 약했다는 것, 그리고 온디바이스용 아주 작은 모델까지 서비스마다 다른 크기가 필요하다는 것. 저는 세 번째가 가장 현실적인 이유라고 봅니다. 공개 인코더를 가져다 쓰면 그 회사가 공개한 크기 중에서 골라야 하는데, 카카오처럼 서비스가 많고 일부는 단말 위에서 돌아야 하는 회사라면 크기를 고를 수 있는 능력 자체가 자산입니다.
두 번째 이유, 한국어와 한국 문화도 생각보다 인코더 단계의 문제입니다. 흔히 한국어 성능은 언어모델이 책임진다고 생각하지만, 메뉴판 귀퉁이의 작은 한글이나 공문서의 표 안 글자를 읽는 일은 언어모델에 도착하기 전에 결판이 납니다. 인코더가 받침 하나를 뭉개 버리면 뒤의 언어모델은 그걸 추측으로 메울 수밖에 없어요. 그래서 한국어 OCR과 문서 이해를 원하는 회사라면, 한국어로 학습된 언어모델만큼이나 한글을 세밀하게 보는 눈이 필요합니다. 카카오가 '선택이 아닌 필수'라고 표현한 것도 이 맥락입니다.
그렇다고 직접 만드는 길이 싼 건 아닙니다. 글이 표로 정리한 빅테크의 학습 규모가 그걸 보여 줘요. SigLIP2는 비공개 120억 개 이미지·텍스트 쌍으로 400억 샘플을, Perception Encoder는 비공개 54억 쌍으로 580억~860억 샘플을 학습했습니다. 구조도 복잡합니다. SigLIP2는 이미지·텍스트 인코더를 시그모이드 손실(Sigmoid Loss)로 함께 학습하면서 캡셔닝과 그라운딩을 위한 자기회귀 디코더(Autoregressive Decoder), 지수 이동 평균(EMA) 인코더를 활용한 자기 증류(Self-Distillation), 마스크 예측(Masked Prediction)까지 얹고, Perception Encoder는 CLIP 방식 대조 학습(Contrastive Learning)에 어텐션 풀링과 LAMB 옵티마이저 등 여덟 가지 구성을 덧붙입니다. 구성 요소가 많으면 공개되지 않은 세부에서 헤매기 쉽고, 다 구현해도 그 데이터와 학습량은 감당하기 어렵다는 게 카카오 팀의 진단이었습니다.
손실은 하나로, 복잡도는 데이터로
카카오가 택한 방법은 GenLIP입니다. 학습 목표는 일반 언어모델과 똑같은 다음 토큰 예측(Next Token Prediction) 하나예요. 다만 이미지를 참조해 그 이미지에 대한 자세한 설명을 생성하도록 학습합니다. 설명을 정확히 생성해야 손실이 낮아지니, 그 과정에서 이미지에서 세밀한 특징을 뽑아내는 인코더가 저절로 길러진다는 원리입니다.
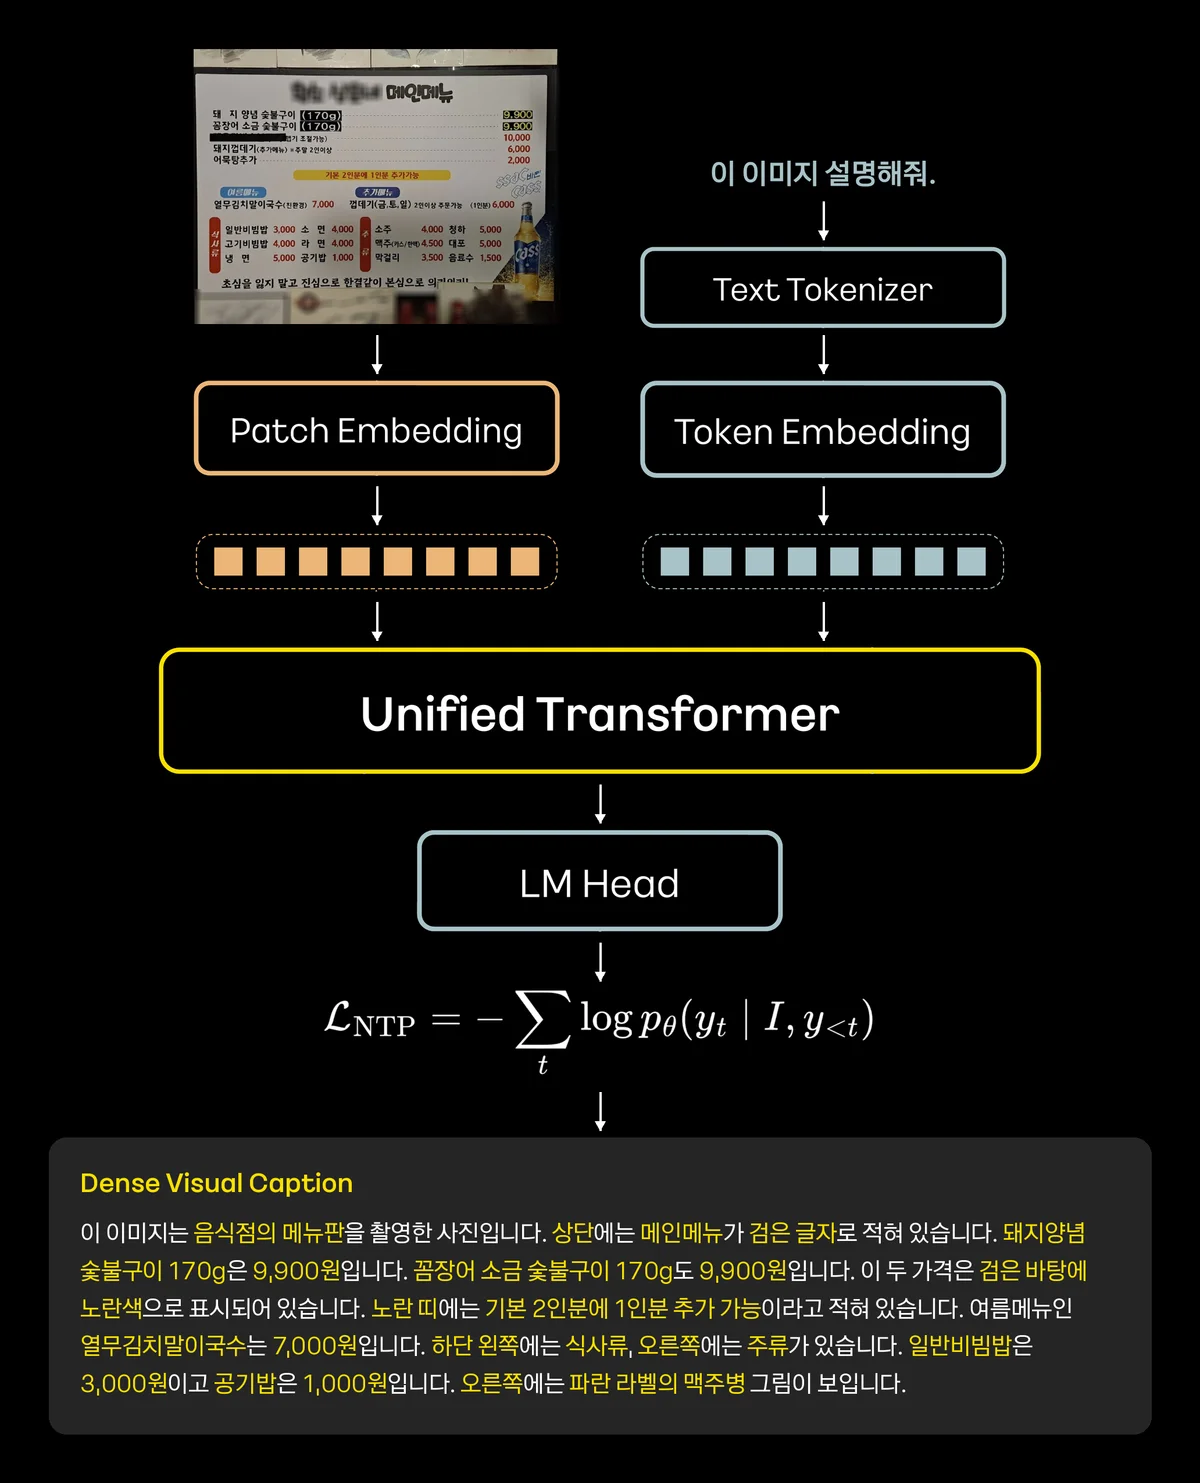
핵심 설계는 어떤 캡션을 예측하게 하느냐였습니다. 팀은 이미지 속 작은 글자와 세부까지 담은 Dense Visual Caption을 대규모로 만들었어요. "돼지양념 숯불구이 170g은 9,900원입니다", "오른쪽에는 파란 라벨의 맥주병 그림이 보입니다" 같은 문장은 글자와 색을 실제로 읽어야만 맞출 수 있습니다. 손실 함수는 단순하게 두고, 이미지를 제대로 봐야만 맞출 수 있는 데이터를 구성해 Unified Transformer가 좋은 시각 특징을 뽑도록 유도한 거죠.
저는 이 대목이 이 글에서 다른 팀이 가장 쉽게 가져갈 수 있는 교훈이라고 봅니다. 목표 함수에 장치를 하나씩 더할 때마다 구현과 디버깅 비용은 곱으로 늘어나는데, 그 복잡도를 데이터 설계로 옮기면 실험 루프가 단순해집니다. 추천이든 검색이든 랭킹 모델을 만드는 팀이 손실 항을 늘리기 전에 라벨부터 다시 보는 것과 같은 감각이에요. 아쉬운 건 정작 그 데이터의 규모와 구축 비용이 글에 없다는 점입니다. 빅테크의 학습량은 표로 보여 주면서 자기 데이터 숫자는 밝히지 않았으니, 이 방식이 얼마나 싸게 먹혔는지는 독자가 판단할 수 없습니다. 단순한 손실의 대가를 데이터 쪽에서 얼마나 치렀는지가 이 방법론의 진짜 가격표일 텐데요.
LLM의 자식으로 태어난 덕분에
이 인코더는 무작위 가중치가 아니라 Kanana-2 LLM의 가중치에서 학습을 시작했습니다. 비슷한 손실에 도달하는 데 필요한 학습 단계가 약 4분의 1로 줄었다고 하니, 약 4배의 학습 효율입니다. 이미 문장을 유창하게 만드는 가중치에서 출발하니 '설명을 생성하라'는 과제가 처음부터 덜 낯선 셈이죠.
구조를 물려받은 효과는 추론 쪽에서 나왔습니다. 작은 글자를 읽으려면 고해상도 입력이 필요한데, 해상도가 오르면 이미지 토큰이 늘고 모든 토큰 쌍을 계산하는 Full Attention은 토큰이 두 배면 계산량이 네 배, 이미지가 네 배면 열여섯 배가 됩니다. Kanana-2 LLM에서 물려받은 슬라이딩 윈도우 어텐션(Sliding Window Attention; SWA)은 각 토큰이 주변 일정 범위만 보게 해서 계산량을 O(N²)에서 O(NW)로 줄이고, 이미지 전체 정보를 놓치지 않도록 Full Attention 레이어를 군데군데 섞었습니다. 헤드마다 Key·Value를 따로 두는 멀티 헤드 어텐션(Multi-Head Attention) 대신 여러 Query 헤드가 Key·Value를 나눠 쓰는 그룹 쿼리 어텐션(Grouped Query Attention; GQA)도 함께 물려받았고요.
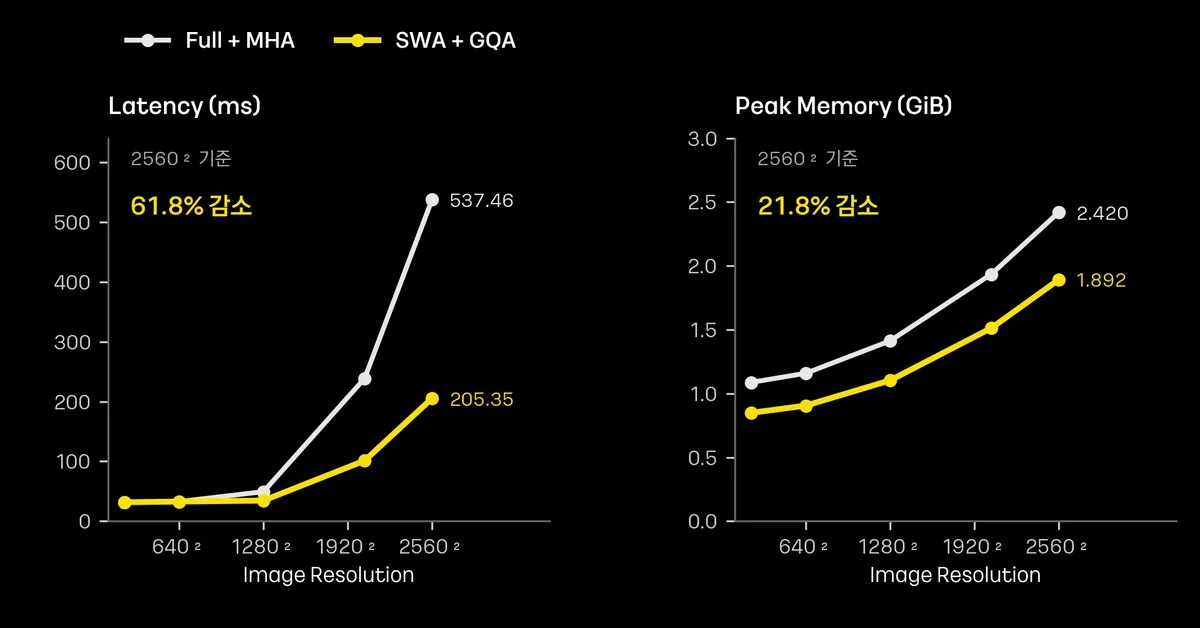
그래프가 보여 주듯 저해상도에서는 이득이 작고 고해상도로 갈수록 차이가 벌어집니다. 2560×2560 해상도에서 지연 시간은 61.8%, 최대 메모리 사용량은 21.8% 줄었습니다. 문서 이미지와 스크린샷을 많이 다루는 서비스라면 이 곡선이 실제 서빙 비용을 결정합니다. 학습도 224² 고정 해상도에서 시작해 원본 비율을 유지한 최대 640², 최대 1,280²로 단계적으로 키웠는데, 처음엔 이미지를 전혀 이해하지 못하는 모델에게 작은 그림부터 보여 주는 커리큘럼입니다.
라인업도 같은 족보에서 갈라졌습니다. 약 9억 파라미터 Large를 만든 뒤, 레이어 수·내부 차원·어텐션 헤드·FFN 네 축으로 순차 프루닝(Pruning)해 Medium(약 4억), Small(약 2억), Tiny(약 1억)의 시작 가중치를 얻고, Large를 선생(Teacher)으로, 각 크기를 학생(Student)으로 삼아 지식 증류(Knowledge Distillation)했습니다. 정답 토큰 하나가 아니라 전체 어휘에 대한 확률 분포를 맞추게 하는 Full-Vocabulary KL 증류 덕분에, 작은 모델이 "연보라색"뿐 아니라 "분홍색"이나 "흰색"처럼 Large가 이미 알고 있는 연관성까지 학습 신호로 받습니다. 가장 작은 Tiny에는 자기가 생성한 토큰을 교정받는 On-Policy Distillation까지 더했고요. 큰 모델 하나를 잘 만들면 작은 모델들이 거기서 싸게 파생되는 구조라, 서비스마다 다른 크기가 필요하다는 처음의 이유와 정확히 맞물립니다.
프루닝 기준도 하나하나 뜯어볼 만합니다. 레이어는 없앴을 때 선생 모델과의 KL 발산(Kullback-Leibler Divergence) 변화가 가장 작은 것, 즉 빼도 지장이 적은 것부터 덜어냈습니다. 내부 차원은 활성값에 주성분 분석(PCA)을 적용해 활성값을 대표하는 주요 방향을 찾고 그 방향 중심으로 정보를 남겼고, 어텐션 헤드와 FFN은 활성값 중요도로 골랐어요. 헤드를 고를 때 GQA의 그룹 구조를 유지했다는 대목은 작지만 중요합니다. 그룹을 깨뜨리면 물려받은 추론 효율이 같이 깨지니까요. 줄이는 기준을 '모델이 실제로 쓰는 것'의 측정으로 정했다는 점이 좋습니다. 비율을 정해 놓고 일괄로 깎는 방식보다 손이 많이 가지만, 작은 모델의 성능이 어디서 무너지는지를 먼저 묻는 방식이에요.
On-Policy Distillation이 푸는 문제는 생성 모델을 다뤄 본 사람에게 익숙합니다. 학습 때는 늘 정답 문장을 이어받아 다음 토큰을 맞히지만, 실제로 쓸 때는 자기가 방금 만든 토큰을 이어받아야 합니다. 표현력이 부족한 작은 모델은 한 번 틀린 단어를 쓰면 그 틀린 맥락 위에서 계속 틀려 나가죠. 그래서 Tiny가 직접 생성한 토큰 위에서 선생 모델의 교정 신호를 받게 했습니다. 1억 파라미터로 '아는 것'뿐 아니라 '틀렸을 때 돌아오는 법'까지 배우게 한 셈입니다. 이 단계를 가장 작은 모델에만 더했다는 점도 합리적입니다. 큰 모델일수록 처음부터 덜 틀리니 이 비용을 들일 이유가 작죠.
성적표가 나온 경기장
이제 평가입니다. 비교 실험은 지난 7월 공개한 Kanana-2-1.3b-instruct를 언어모델로 고정하고, ViT → 프로젝터 → LLM 구조를 유지한 채 비전 인코더만 바꿔 같은 조건에서 학습·평가했습니다. STEM·퍼즐부터 한국어 OCR·문서 이해, 한국어 시험, 한국 문화 이해까지 9개 영역 42개 벤치마크로, 구글·메타·애플·알리바바의 공개 인코더와 4억·1억 파라미터 규모에서 각각 겨뤘어요.
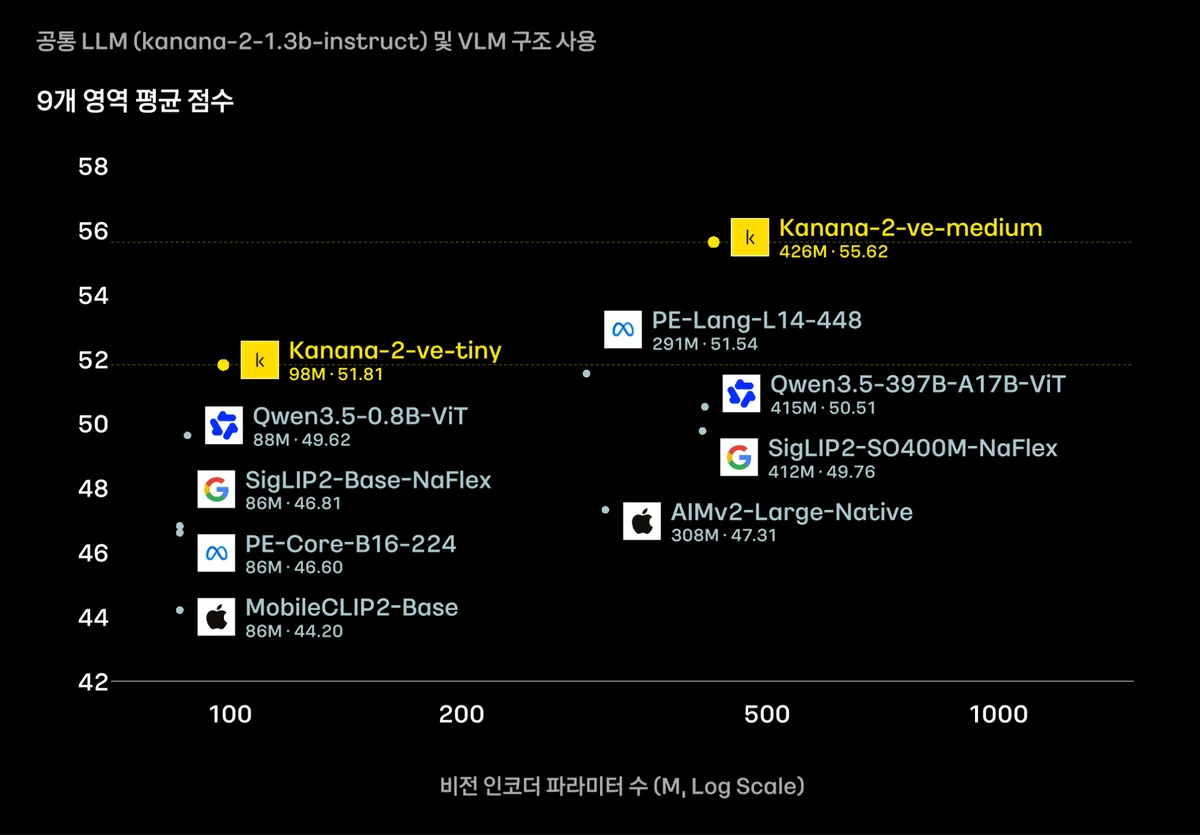
결과는 좋습니다. 9,800만 파라미터 Tiny는 평균 51.81점, 4억 2,600만 파라미터 Medium은 평균 55.62점으로 각 체급 최고였고, Tiny는 9개 영역 중 8개에서 1위, 시각적 위치 인식 67.8점, 한국어 OCR·문서 이해 65.6점을 냈습니다. 1억도 안 되는 Tiny가 4억 규모 비교 모델 4종보다 평균이 높았다는 점이 특히 눈에 띕니다. 팀은 Tiny가 시각적 위치 인식(Visual Grounding)과 한국어 OCR·문서 이해에서 강한 이유를 작은 글자와 위치 정보를 놓치지 않도록 학습한 방향에서 찾습니다. 메뉴판에서 음식 이름과 가격을 함께 읽으려면 글자 자체뿐 아니라 어느 글자가 어느 가격 옆에 있는지를 알아야 하니까요. Dense Caption이라는 데이터 설계가 점수표의 바로 그 칸에서 값을 받은 셈이라, 이 대목은 방법론과 결과가 잘 맞물립니다.
그런데 이 경기장을 한 번 더 보겠습니다. 비교에 쓴 언어모델은 Kanana-2이고, Kanana 인코더는 Kanana-2의 가중치에서 태어났습니다. 같은 집안에서 자란 두 모델은 표현 공간의 결이 비슷할 가능성이 크고, 그러면 프로젝터가 둘을 잇는 일도 수월합니다. '인코더만 바꾼 같은 조건'은 공정한 설계지만, 그 조건 자체가 Kanana 인코더에게 홈그라운드였을 수 있다는 뜻이에요. 다른 회사의 LLM에 붙였을 때도 같은 격차가 나는지는 이 글로는 알 수 없습니다. 9개 영역 중 셋이 한국어·한국 문화 특화라는 점도 '글로벌 최고 수준'이라는 제목을 읽을 때 감안해야 하고요. 저는 이 결과를 거짓이라고 보지 않습니다. 다만 '카카오 스택 안에서 최고'와 '아무 스택에서나 최고'는 다른 주장이고, 글은 앞의 것만 증명했습니다.
족보의 반대편 얼굴도 하나 있습니다. 카카오 팀은 LLM이 발전할 때마다 비전 인코더도 함께 발전하는 선순환 구조를 마련했다고 말합니다. 맞는 말이지만, 같은 문장을 뒤집으면 인코더가 LLM에 묶였다는 뜻도 됩니다. LLM의 구조를 크게 바꾸면 인코더도 다시 학습해야 할 가능성이 크죠. 카카오처럼 LLM부터 옴니 모델 Kanana-o의 모든 구성 요소를 직접 만드는 회사에는 이 결합이 장점이고, 모델 공급자를 바꿔 가며 쓰는 회사에는 같은 결합이 짐입니다.
우리 회사도 인코더를 만들어야 할까
이 개발기를 읽고 "우리도 자체 인코더를 만들자"는 결론을 내는 팀이 있을까 봐 조건을 정리해 두겠습니다. 카카오의 세 가지 이유를 거꾸로 읽으면 직접 만들어도 되는 조건이 나옵니다. 첫째, 이미 자체 LLM이 있어서 그 가중치를 출발점으로 쓸 수 있는가. 이 개발기의 학습 효율 4배와 고해상도 효율은 전부 거기서 나왔으니, 자체 LLM이 없다면 이 지름길은 처음부터 닫혀 있습니다. 둘째, 서비스마다 다른 크기의 인코더가 필요할 만큼 제품이 많은가, 특히 단말 위에서 돌아야 하는 제품이 있는가. 셋째, 공개 인코더가 놓치는 시각 영역, 예컨대 작은 한글이나 특정 산업 문서가 핵심 기능인가.
셋 다 해당하지 않는 팀이라면 답은 거의 언제나 '공개 인코더를 가져다 미세 조정'입니다. 하나만 해당한다면, 그것도 세 번째라면, 인코더 전체를 만들기보다 Dense Caption 같은 데이터 설계를 빌려 공개 인코더를 자기 도메인으로 끌어오는 쪽이 비용 대비 효과가 클 겁니다. 카카오가 직접 만든 이유는 기술적 자존심이 아니라 LLM부터 옴니 모델까지 전부를 자체 스택으로 가져가겠다는 사업 결정의 일부였고, 그 결정이 없는 회사가 인코더만 따라 만들면 족보 없는 자식을 키우는 셈입니다.
그래서 누가 이걸 가져다 쓰면 되나
이번에 공개된 건 Medium(426M)과 Tiny(98M)의 가중치이고, 연구·개발은 물론 상업적 활용도 가능한 Kanana-open 라이선스입니다. 저는 이 공개가 국내 팀들에게 실제로 쓸모 있다고 봅니다. 한국어 문서, 영수증, 메뉴판, 앱 스크린샷처럼 작은 한글이 많은 이미지를 다루는 서비스에서 1억 파라미터 이하 인코더는 단말 위에서 돌릴 수 있는 크기고, 그 체급에서 한국어 OCR·문서 이해에 강하다는 결과는 다른 데서 구하기 어렵습니다.
쓰는 방법은 이렇게 권하고 싶습니다. 공개 벤치마크 점수를 믿기보다, 우리가 쓰는 언어모델에 Tiny를 붙여 우리 데이터로 직접 재 보세요. 홈그라운드 효과가 우리 스택에서는 얼마나 줄어드는지, 고해상도 문서에서 지연 시간 곡선이 우리 서빙 환경에서도 같은 모양인지. 이 두 가지를 확인한 팀에게 이 공개는 큰 선물이 될 거고, 확인하지 않은 팀에게는 그냥 또 하나의 1위 발표로 남을 겁니다. 그리고 인코더를 직접 만들 생각이 없는 팀이라도 손실은 단순하게, 복잡도는 데이터로 옮긴다는 이 팀의 설계 원칙만큼은 다음 모델링 회의에 들고 갈 가치가 있습니다.